日本時間2026年11月13日の未明から、Microsoft 365でOutlookのメールが開けなくなる大規模な障害が世界中で起き、復旧まで約24時間かかりました。 日本でも、政府や自治体、大学、企業でメールが止まりました。Microsoftは11月15日(現地時間)に暫定の報告を出し、原因を「7月の修正に潜んでいた不具合に、負荷の増加と容量の減少が重なったこと」と説明しています。
「なぜ丸1日も止まったの?」「サイバー攻撃じゃないの?」「また起きるの?」。仕事が止まった方ほど、こう感じているはずです。
この記事では、Microsoftの説明をもとに、障害の経緯、3つの要因が重なった仕組み、サーバーの80%超が止まった連鎖、復旧に時間がかかった理由を、専門用語をかみ砕いて整理します。あわせて、日本での影響と、利用者や情シスの担当者が今のうちにできることもまとめます。内容は2026年11月17日時点で、Microsoftの公式ステータス、公式Xアカウントの投稿、Microsoft幹部による暫定報告の説明を確認したものです。
Microsoft 365大規模障害の原因は「7月の修正に潜んでいた不具合」
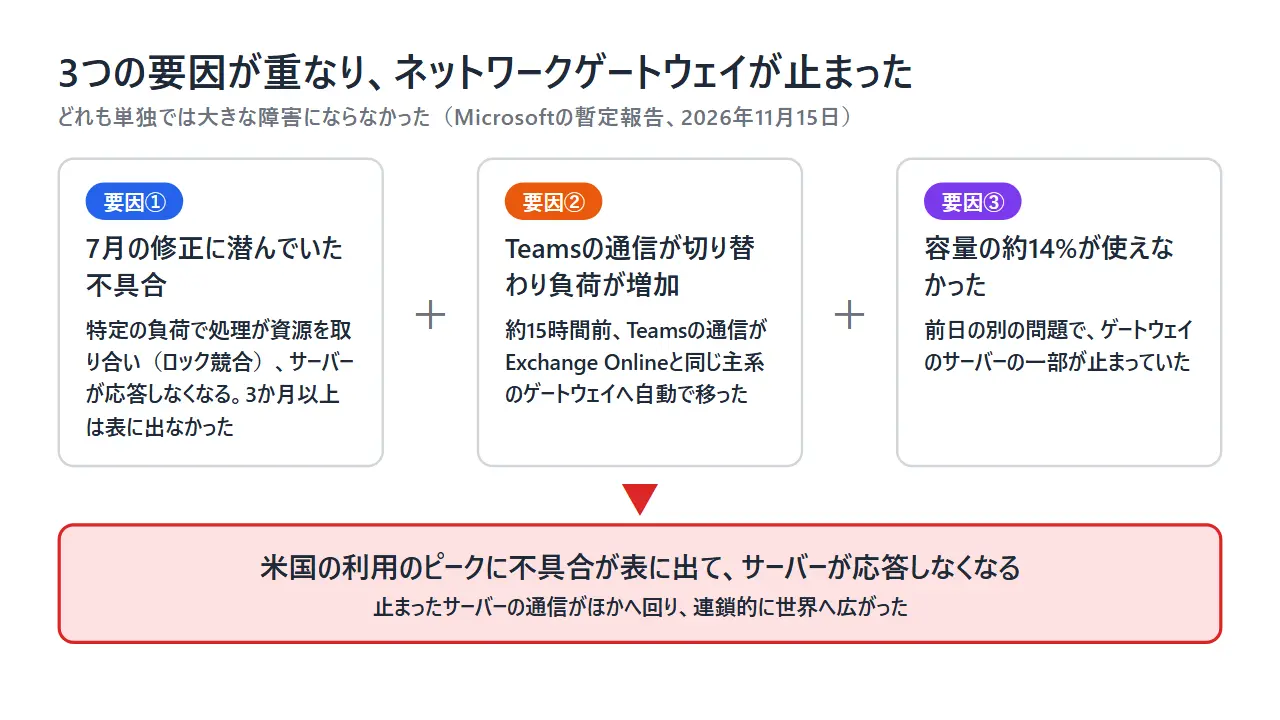
Microsoftの説明では、障害の中心は、Microsoft 365の多くのサービスの入り口にあたる「ネットワークゲートウェイ」です。ここで、3つの要因が同時に重なって世界規模の停止になりました。 サイバー攻撃やAIによるものではない、ともMicrosoftは説明しています。
| 項目 | 内容(2026年11月17日時点) |
|---|---|
| 発生 | 日本時間11月13日1時20分ごろ(米国時間11月12日) |
| 影響の終了 | 日本時間11月14日1時10分(約24時間) |
| 影響が大きかったサービス | Exchange Online(Outlookのメール)。Teams、SharePoint、Copilotなど約20サービスにも影響 |
| 止まった場所 | 多くのサービスの入り口にあたる「ネットワークゲートウェイ」のサーバー |
| 原因① | 7月から展開した修正に潜んでいた不具合。特定の負荷でサーバーが応答しなくなる |
| 原因② | 約15時間前に、Teamsの通信が同じゲートウェイに切り替わり、負荷が増えた |
| 原因③ | 前日の別の問題で、ゲートウェイの容量の約14%が使えなかった |
| いちばん悪いとき | サーバーの80%超が応答しない状態 |
| サイバー攻撃・AI | 関係ない、とMicrosoftは説明 |
| 最終報告 | 再発防止策の全体を含めて、今週中(11月20日ごろ)に出る予定 |
障害が始まったのは、米国で利用が多い時間帯でした。1つのサーバーが止まると、その分の通信がほかのサーバーへ回り、回った先も同じ不具合で止まる、という連鎖が起き、2時間足らずで世界中に広がっています。
私がこの説明でいちばん驚いたのは、不具合そのものより、障害に備えるための仕組みが、障害を広げる側に回っていたことです。この点は、後の見出しで詳しく書きます。
障害の経緯:日本時間11月13日1時20分から約24時間
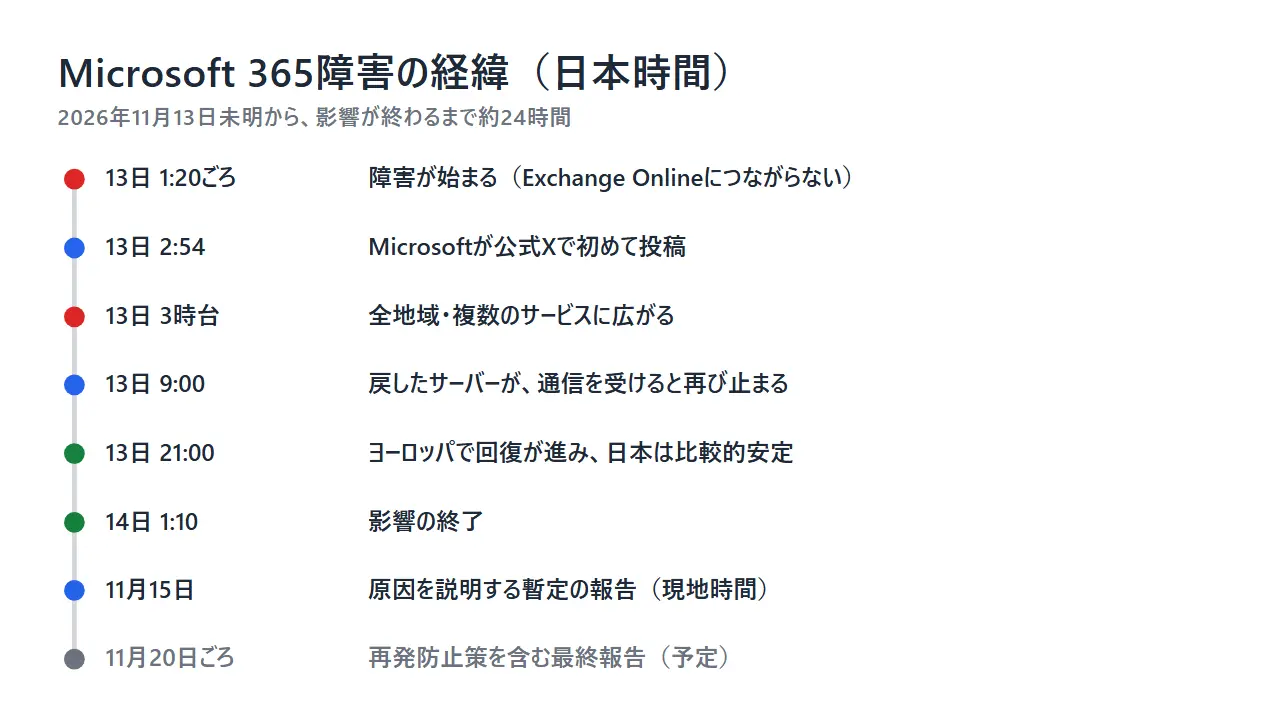
障害は日本時間13日の1時20分ごろ、Exchange Onlineのメールボックスにつながらない問題として始まりました。 3時台には全地域・複数のサービスに広がり、日本では13日の朝から業務に影響が出ています。影響が終わったのは、14日の1時10分です。
| 日時(日本時間) | 出来事 |
|---|---|
| 11月13日 1時20分ごろ | 障害が始まる(Microsoftの最終報告が記録した開始時刻) |
| 同日 2時54分 | Microsoftが公式Xで、米州でメールボックスにつながらない報告を調べていると初めて投稿 |
| 同日 3時7分 | 影響がどの地域の利用者にも及びうると更新 |
| 同日 3時26分 | Exchange Online以外のサービスにも広がり、複数サービスの障害(MO1550821)として扱いが始まる |
| 同日 7時00分 | サーバーの中核となる処理が過負荷になり、応答しなくなっていると更新 |
| 同日 9時00分 | 戻したサーバーが、通信を受けると再び応答しなくなると更新 |
| 同日 18時03分 | 遅れたメールを守るため、メールの配送を待つ時間を48時間に延ばす |
| 同日 21時00分 | ヨーロッパで回復が進み、日本は比較的安定と更新 |
| 11月14日 1時10分 | 影響の終了(Microsoftの最終報告が記録した時刻) |
| 同日 2時57分 | Microsoftが謝罪し、サイバー攻撃やAIとは関係のない技術的な問題だと説明 |
| 同日 13時15分 | 障害の通知が「サービス復旧済み」になる |
| 11月15日(現地時間) | 原因を詳しく説明した暫定の事後報告を公開 |
Microsoftの障害の番号は2つあります。Exchange Online(Outlookのメール)の障害が EX1550543、ほかのサービスへの影響をまとめた障害が MO1550821 です。管理者は、この番号でMicrosoft 365 管理センターのサービス正常性から経緯を確かめられます。
影響を受けたサービスは、最終的に約20に増えました。Outlookでは、Web版、デスクトップ版、スマホのメールアプリのどの方法でもメールボックスを開けないことがあり、メールの配送も遅れました。Teamsは予定表や会議の予約などExchange Onlineを使う機能に影響が出た一方、チャットや会議そのものは大半の時間で使えています。Copilotも、メールや予定表を読む機能が使えなくなりました。
私は、「Teamsは動くのに、Outlookは開けない」という状態が、利用者の混乱を大きくしたと見ています。何が止まっていて何が使えるのかが、利用者からは見えにくかったからです。
3つの要因が重なった仕組み:不具合・負荷の増加・容量の減少
Microsoftが11月15日に出した暫定の報告では、どれか1つだけなら大きな障害にならなかった3つの要因が、同じタイミングで重なったと説明しています。MicrosoftのCharles Lamanna氏が、報告の要約を自身のXアカウントに投稿しています。
More details on the root cause can be found in the Microsoft 365 Admin center, and an abridged version can be found below.
— Charles Lamanna (@clamanna) 2026年11月16日
We are deeply sorry for the impact to all our customers and recognize the impact that this has on their normal business & operations.
The incident on… https://t.co/p8mUHxDe67
止まったのは「ネットワークゲートウェイ」と呼ばれる部分です。利用者のパソコンやスマホからの通信を最初に受け取り、メールボックスなど奥のサーバーへ取り次ぐ、いわば建物の受付にあたります。ここが止まると、奥のデータが無事でも、利用者はたどり着けません。
要因① 7月の修正に潜んでいた不具合(ロック競合)
1つ目は、ゲートウェイのサーバーだけに向けて作られた修正に入っていた不具合です。特定の負荷がかかると、サーバーの中の処理どうしが同じ資源を取り合って待ち続け(ロック競合)、サーバーが応答しなくなります。
この修正は7月に展開が始まり、数週間かけて世界中に行き渡りました。そのあと3か月以上、問題は一度も表に出ていません。 Microsoftは、Windows全般にはこの不具合も修正も関係しないと説明しています。
事前の負荷テストで見つからなかった理由も説明されています。この不具合は、コア数の多い新しいサーバーほど起きやすいものでした。一方で、テストはコア数の少ない性能の低いサーバーを中心に行われていて、通信の種類の組み合わせも本番とは違っていました。
要因② Teamsの通信が切り替わり、負荷が増えた
2つ目は負荷の増加です。Microsoft 365には、障害に備えて、独立した2つのゲートウェイの仕組みがあります。障害の約15時間前、Teamsの通信が自動でもう一方から「主系」のゲートウェイへ切り替わりました。主系は、Exchange Onlineも使っているゲートウェイです。
この切り替え(フェイルオーバー)は、ふだんの運用の一部で、障害に強くするための仕組みそのものです。ただ、今回はこれで主系の負荷が増え、通信の傾向も変わりました。
要因③ 前日の別の問題で、容量の約14%が使えなかった
3つ目は容量の減少です。前日に起きた別の問題で、ゲートウェイのサーバー容量の約14%が使えない状態でした。通常の保守で戻る予定で、余裕は十分にあったため、これだけでは影響は出ていません。
負荷が増え、容量が減ったところで、米国の利用のピークを迎えました。このとき、7月の不具合が表に出て、処理待ちの要求がたまり続け、サーバーが応答しなくなりました。
私は、3つとも「ふだんなら問題にならないこと」だった点が重要だと考えています。どれも単独では警報が鳴らない程度のことで、重なって初めて大きな障害になりました。
サーバーの80%超が止まった連鎖:障害に備える仕組みが裏目に
2時間足らずで、ゲートウェイのサーバーの80%超が応答しなくなりました。 広げたのは、止まったサーバーの利用者を、自動で正常なサーバーへ振り分ける仕組みです。
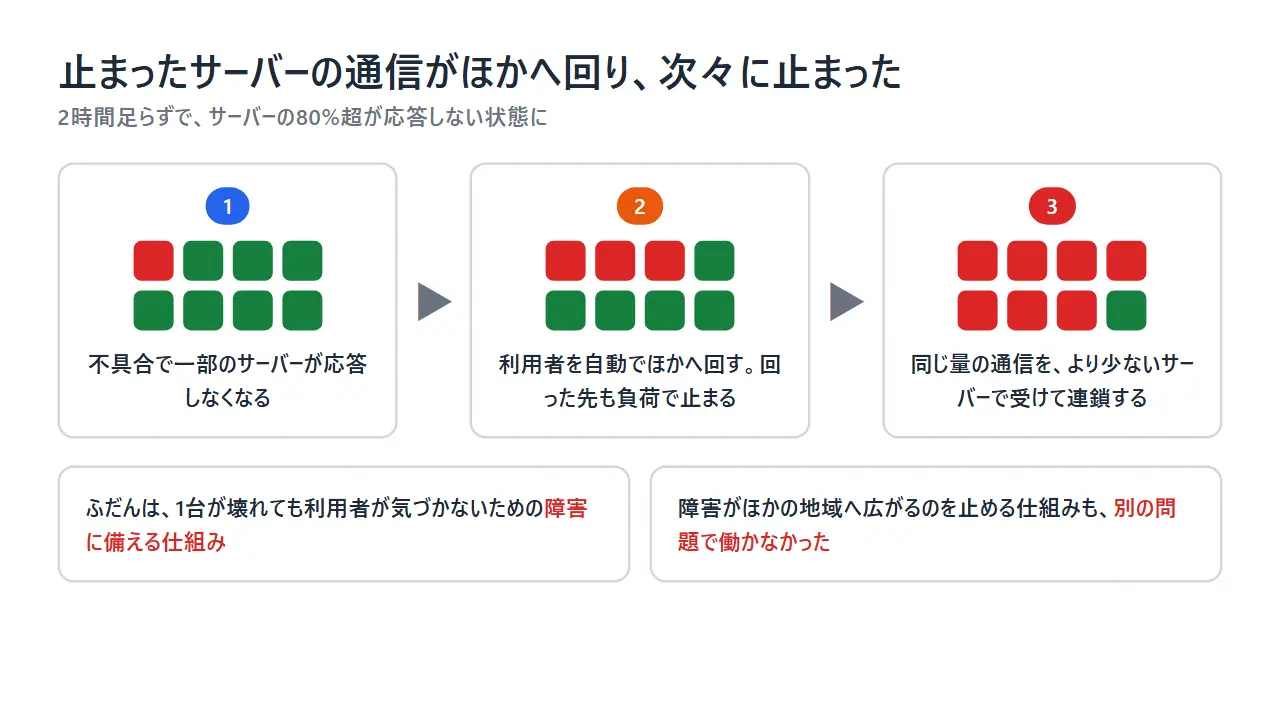
サーバーがつながらなくなると、Microsoftの通信の管理の仕組みは、利用者を自動でほかの正常なサーバーへ回します。ふだんはこれのおかげで、1台が壊れても利用者は気づきません。
ところが今回は、回った先のサーバーにも同じ不具合が潜んでいました。同じ量の通信を、より少ないサーバーで受けることになり、回った先も次々に止まりました。サーバーからサーバーへ止まっていく、連鎖的な障害(カスケード障害)です。
本来は、ゲートウェイは数千の小さな単位に分かれ、それが地域ごとにまとめられていて、障害がほかの単位や地域へ広がらないようになっています。船の隔壁のような仕組みです。しかし今回は、別の問題でこの隔壁も働かず、障害は世界中のゲートウェイに広がりました。
止まったサーバーの分の負荷が、残ったサーバーにどうかかっていくのかは、次の英語の動画が図で分かりやすく見せています。障害の最中に、Microsoftの公開した情報だけをもとに作られた解説です。

動画では、サーバーの3分の1が抜けると残りは1.5倍、半分が抜けると2倍、4分の3が抜けると4倍の仕事を受けることになる、と計算で示しています。また、正常かどうかを確かめる「ヘルスチェック」は、壊れたサーバーと忙しすぎて返事が遅れたサーバーを区別できません。そのため、負荷で遅くなったサーバーまで次々に外され、残りがさらに苦しくなる、と解説しています。
私は、ここが今回の障害でいちばん教訓になる点だと見ています。不具合を完全になくすことはできません。それより、Teamsの自動の切り替えも、止まったサーバーの通信の振り分けも、障害に備える仕組みがすべて同じ方向に一斉に動いたことが、丸1日の停止につながりました。
復旧に丸1日かかった理由:戻したサーバーがまた止まる
復旧が長引いた理由は、主に2つです。戻したサーバーに、待っていた通信が一気に押し寄せて再び止まったことと、数か月前の変更なので、すぐに元に戻せなかったことです。
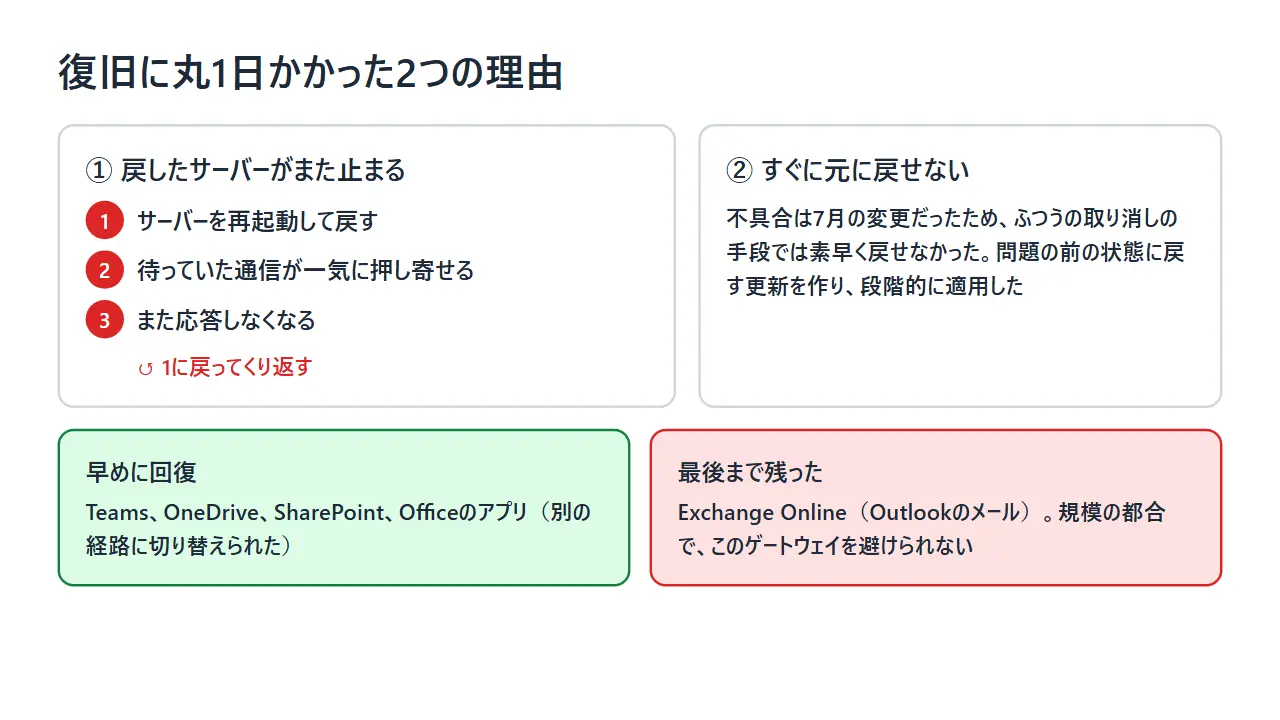
1つ目は、再起動の繰り返しです。サーバーを再起動して戻すと、つながるのを待っていた大量の通信がすぐに集まり、また応答しなくなりました。Microsoftの自動で復旧する仕組みは、ほとんどのサーバーが一斉に応答しなくなる状態からの復旧を想定していませんでした。
2つ目は、元に戻すのが難しかったことです。新しい変更で問題が起きたときは、ふつうは変更を取り消したり、機能を切ったりしてすぐに戻せます。今回の不具合は7月の変更だったため、そうした通常の手段では素早く戻せませんでした。
Microsoftは原因を確かめたあと、処理の流れを問題が起きる前の状態に戻す更新を作りました。そして、サーバーをまとまった単位(1つの地域の半分以上など)で切り離し、更新して再起動し、様子を見ながら段階的に戻しています。
一方で、Teams、OneDrive、SharePoint、Officeのアプリは、問題のゲートウェイを避けて別の経路に切り替えられたため、早めに回復しました。Exchange Onlineは規模の都合で、このゲートウェイを避けられません。メールだけが最後まで残ったのは、このためです。
私は、Microsoftが「時間はかかったが、段階ごとに安定を確かめながら戻した」と説明している点には納得しています。一気に戻せば、また同じ連鎖が起きた可能性が高いからです。
サイバー攻撃やAIが原因ではない?Microsoftの説明と、途中で変わった説明
Microsoftは、今回の障害はサイバー攻撃やAI・エージェントとは関係のない技術的な問題だと説明しています。 障害中から、悪意のある活動の兆候はないとくり返し伝えていました。
日本時間14日2時57分には、Microsoft 365の公式Xアカウントが謝罪とあわせて、次のように投稿しています。
We are deeply sorry for the disruption this incident has caused our customers and partners. We know the trust they place in our services and take that responsibility extremely seriously. We are seeing broad recovery and stability across our services.
— Microsoft 365 Status (@MSFT365Status) 2026年11月13日
This was a technical issue…
この投稿では、「以前のネットワーク容量の増強で生じた問題が、最近のネットワークの変更のあとに表に出た」と説明していました。11月15日の暫定報告では、これが「7月の修正に潜んでいた不具合」と、負荷の増加と容量の減少の組み合わせとして、具体的に説明されています。
障害の最中、Microsoftの説明は何度も変わりました。原因の調べが進むにつれて、見立てが変わっていったためです。
| 時点(日本時間) | Microsoftの説明 |
|---|---|
| 13日 3時19分ごろ | 複数の地域で、一部のインフラの負荷が上がっている |
| 13日 4時18分 | 負荷の上昇は通信の増加ではなく、多数のサーバーが予期せず使えなくなったため |
| 13日 4時43分 | サーバーが自動のヘルスチェックに失敗して、使えなくなっている |
| 13日 4時57分 | 影響の開始と関係する最近の変更は見つかっていない |
| 13日 10時06分 | 影響の開始と関係する、最近のネットワーク構成の変更の巻き戻しを始めた |
| 14日 2時57分 | 以前の容量増強で生じた問題が、最近のネットワーク変更のあとに表に出た |
| 11月15日(暫定報告) | 7月の修正の不具合に、負荷の増加(Teamsの切り替え)と容量の約14%減が重なった |
なお、障害のあとに、AIの導入や人員削減との関係を指摘する声もネット上で出ています。ただ、MicrosoftはAIとの関係をはっきり否定していて、人員削減との関係を裏付ける公式の情報もありません。
私は、障害の最中に「最近の変更とは関係ない」と言った数時間後に、変更の巻き戻しを始めている点は、説明として分かりにくかったと感じています。一方で、4日後に数値まで入れた説明を出したことは、大きな障害の説明としては率直だと評価しています。
日本では政府・自治体・大学のメールも止まった
障害は日本の朝の業務時間に重なり、政府の業務の仕組みにまで影響が出ました。 13日の朝から、省庁、自治体、大学、企業が相次いで「メールが使えない」と公表しています。
政府では、各府省庁が使う共通の業務環境「ガバメントソリューションサービス(GSS)」で、Outlookによるメールの送受信などができなくなりました。13日の会見で、尾崎官房副長官と古川デジタル相がそれぞれ説明しています。高市首相は13日、関係する省庁に次の3点を指示しました。
- 電話など、メール以外の連絡手段の確保と周知
- 申請の期限に間に合わない人が、不利益を受けないための対応
- 所管する業界への影響の把握と報告
公表された影響の例は、次のとおりです。
- 国の機関: 内閣府、総務省、法務省、外務省、金融庁などでメールの送受信ができない。国土交通省の地方整備局などでは、問い合わせを電話へ案内
- 自治体: 東京都、愛知県、富山県、三重県などでメールの送受信に支障
- 大学: 鳴門教育大学、東海大学札幌キャンパス、室蘭工業大学などで、OutlookやTeamsなどが使えない
- 企業・イベント: 白水社でメールの送受信ができない。Cybozu Days Japanでは、受講票のメールを確認できない来場者に再発行の窓口を案内
海外でも、米国の大学や議会、ブラジルの裁判所などに影響が出ました。障害の報告を集めるサイトには、最初の1時間ほどで74の国と地域から報告が寄せられています。Microsoft 365とつながる外部のサービスにも影響が広がり、AnthropicのClaudeのMicrosoft 365連携も、メールや予定表の機能の大半が失敗したと公表しています。
私は、メールしか窓口がない行政の手続きや相談窓口が止まったことを、いちばん重く見ています。「メールで問い合わせてください」という窓口は多く、止まったときに利用者側には打つ手がありません。
障害の状況はどこで確かめる?便乗フィッシングにも注意
障害のときは、Microsoftの公式の窓口で状況を確かめ、届いたメールのリンクからは確かめないのが基本です。今回の障害では、障害の番号を使った偽のメールも出回りました。
状況を確かめる場所は、次の3つです。
- Microsoft 365 管理センターのサービス正常性: 会社や学校の管理者が見る、いちばん詳しい情報。障害の番号ごとの経緯や事後報告もここに出る
- Microsoftの公式ステータスページ: 管理センターが開けないときに更新されるページ。サインインせずに見られる
- Microsoft 365 Statusの公式Xアカウント(@MSFT365Status): 大きな障害のときに、経過を投稿する
一般の利用者は、まず社内の情シスや学校の案内を確かめるのが確実です。個人向けのOutlook.comも、今回は影響を受けています。
障害の番号を使った偽のメールに注意
Microsoftのセキュリティの調査チーム(Microsoft Threat Intelligence)は、今回の障害に便乗したフィッシングメールを確認したと公表しています。サービス正常性の通知を装い、本物の障害番号「EX1550543」を書いているため、本物と見分けにくいのが特徴です。
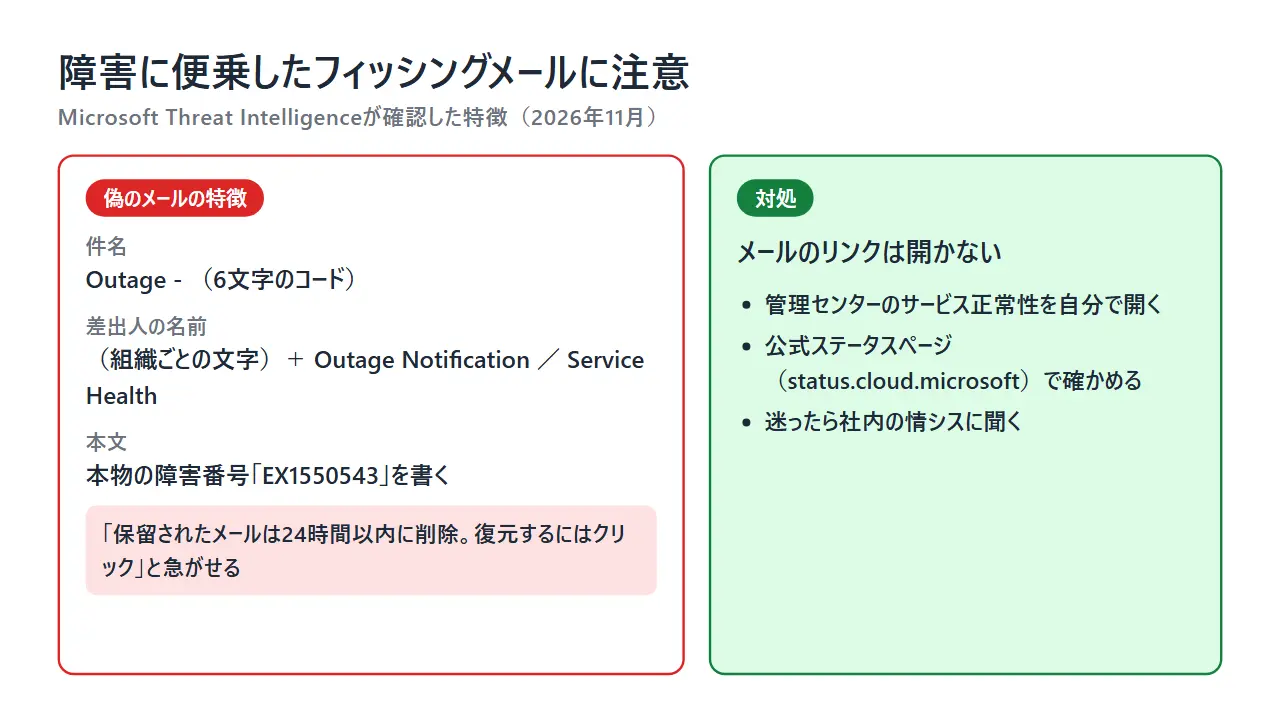
確認されたメールには、次の特徴がありました。
- 件名が「Outage – (6文字のコード)」の形
- 差出人の名前が「(組織ごとの文字)+Outage Notification」や「Service Health」
- 「障害中に保留されたメールは、24時間以内に削除される。復元するにはクリック」と急がせる
Microsoftは、IDやパスワードを盗むフィッシングの特徴に当てはまるとしています(実際に盗まれた被害は確認されていません)。障害の直後は本物の通知が多く届くので、偽物が紛れやすい時期です。メールのリンクは開かず、管理センターや公式ステータスページを自分で開いて確かめてください。
障害中に送ったメールは届いている?
障害中に送ったメールの多くは、遅れて届いています。Microsoftは13日、遅れたメールが送り主に戻されないよう、配送を待つ時間を48時間に延ばしました。ただし、「送れませんでした」という不達の通知(エラーメール)が届いた場合は、そのメールは届いていないので、送り直す必要があります。
私は、大事なメールほど、相手に届いたかを電話やチャットで一言確かめておくのが安全だと考えています。特に、期限のある申請や見積もりのメールです。
「止まったときにどう連絡するか」を決めておくことが、いちばんの備え
今回の障害で、利用者が自分で変えられるのは、止まったときの連絡手段と、便乗した偽メールへの構えです。Microsoft側の仕組みは利用者には直せません。
Microsoftは障害中に説明を何度も改め、11月15日には数値まで出しました。説明の速さと率直さは評価できます。ただ、どれほど大きなクラウドでも、丸1日止まることがあると、今回はっきりしました。
私が今のうちに決めておきたいと考えるのは、次の3つです。
- 連絡手段を2つ持つ: メールとTeamsが止まっても使える、電話やほかのチャットを、取引先や家族と決めておく
- 確かめる場所を覚えておく: 管理センター、公式ステータスページ、公式Xアカウント
- 障害の直後に来た「Microsoftからの通知」を疑う: リンクは開かず、公式の窓口で確かめる
情シスの担当者は、障害が起きた時刻と業務への影響を記録しておくと、あとで上司への報告やSLAの申請に使えます。障害の最中に設定を慌てて変えると、復旧後に別の不具合を招くこともあるので、Microsoft側の障害だと分かったら、設定には手を付けないのが基本です。
よくある質問
Microsoft 365の障害は、いつからいつまでだった?
日本時間で、2026年11月13日の1時20分ごろから、14日の1時10分までです(Microsoftの記録)。約24時間です。障害の通知が「サービス復旧済み」になったのは14日の13時15分で、そのあとも遅れたメールの配送はしばらく続きました。
原因はサイバー攻撃やAIではないの?
Microsoftは、サイバー攻撃やAI・エージェントとは関係のない技術的な問題だと説明しています。 原因は、7月の修正に潜んでいた不具合に、Teamsの通信の切り替えによる負荷の増加と、容量の約14%減が重なったことです。悪意のある活動の兆候はない、とも伝えています。
なぜ復旧に丸1日もかかったの?
戻したサーバーに、つながるのを待っていた通信が一気に押し寄せ、また止まったためです。不具合は7月の変更だったので、ふつうの取り消しの手段ではすぐに戻せませんでした。Microsoftは、サーバーをまとまった単位で更新・再起動し、段階的に戻しました。
障害中に送ったメールは、送り直したほうがいい?
多くは遅れて届いているので、すべてを送り直す必要はありません。Microsoftは、メールの配送を待つ時間を48時間に延ばしました。ただし、不達の通知(エラーメール)が届いたメールは届いていないので、送り直してください。大事なメールは、相手に届いたかを確かめると安心です。
また同じ障害は起きる?Microsoftはどんな対策をする?
Microsoftは、問題の処理を以前の状態に戻す更新、容量の追加、通信の振り分けの監視の強化、連鎖を防ぐための通信の振り分けの制限を済ませたと説明しています。再発防止策の全体は、今週中(11月20日ごろ)の最終報告に入る予定です。
SLA(返金)の対象になる?
会社や学校で使う法人向けの契約では、Exchange OnlineなどにSLA(品質の保証)があり、月の稼働率が99.9%を下回ると、利用料の一部が戻るサービスクレジットの対象になります。自動では戻らず、管理者の申請が必要です。個人向けのプランには、こうした保証はありません。今回の障害だけの特別な補償は、11月17日時点では公表されていません。
障害の状況は、どこで確かめればいい?
管理者はMicrosoft 365 管理センターのサービス正常性、それ以外の人はMicrosoftの公式ステータスページ(status.cloud.microsoft)と公式Xアカウント(@MSFT365Status)で確かめられます。会社や学校のアカウントなら、まず社内の情シスや学校の案内を見るのが確実です。
11月20日ごろの最終報告で、確かめたい2つのこと
Microsoftは、再発防止策の全体を含む最終の事後報告を、今週中(11月20日ごろ)に管理センターで公開する予定です。11月17日時点では、まだ公開されていません。
私が最終報告で確かめたいのは、次の2つです。
- 隔壁が働かなかった「別の問題」の中身: 障害を世界中に広げたのは、ほかの地域へ広がるのを止める仕組みが働かなかったことです。暫定報告では「別の問題」としか書かれていません
- 負荷テストの見直し: コア数の多い新しいサーバーで起きる不具合を、今後どうやって本番の前に見つけるのか
最終報告が出たら、この記事に追記します。会社や学校でMicrosoft 365を使っている方は、まず「止まったときにどう連絡するか」を、今日のうちに周りと決めておいてください。