仕事の資料をChatGPTに貼り付けて要約してもらう。お客さまへのメールの下書きをAIに頼む。便利な一方で、「今入力したこの情報、本当に外に出ていないのだろうか」と手が止まったことはないでしょうか。2026年には、委託先の社員が健康診断に関わる個人情報を生成AIに入力していた事案や、AIとの会話が検索結果に表示されていた問題が続き、その不安は現実のものになりました。
そこで注目されているのが、AIを自分のPCの中だけで動かす「ローカルLLM」です。この記事では、ローカルLLMとは何か、生成AIからの情報漏洩はどこで起きているのか、ローカルLLMで防げることと防げないこと、必要なPCとモデルの選び方、始め方、安全に使うための確認までを1本で整理します。内容は2026年10月時点で確認したものです。
ローカルLLMとは?AIを「自分のPCの中だけ」で動かすこと
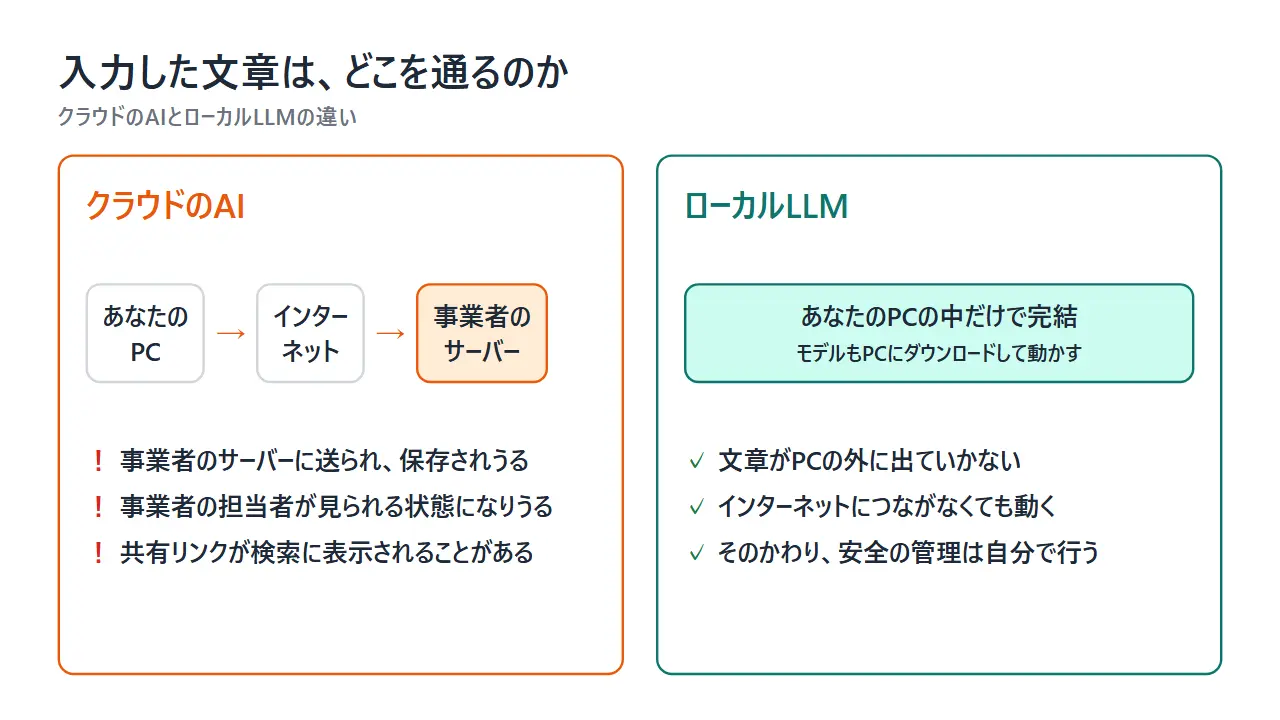
ローカルLLMとは、大規模言語モデル(LLM)を、クラウドではなく自分のPCや社内のサーバーで動かす使い方です。入力した文章が外部のAI事業者のサーバーに送られないこと、インターネットにつながっていなくても動くことが、いちばんの特徴です。
ChatGPTやGeminiのようなクラウドのAIでは、入力した文章(プロンプト)がインターネットを通って事業者のサーバーに届き、そこでAIが答えを作って返してきます。ローカルLLMでは、AIのモデルそのものを自分のPCにダウンロードし、答えを作る計算もPCの中で行います。文章がPCの外に出ていく道が、もともとありません。
ローカルLLMで動かすのは、「オープンウェイト」と呼ばれる、中身(重み)が公開されて誰でもダウンロードできるモデルです。OpenAIのgpt-oss、GoogleのGemma、AlibabaのQwenなどがあります。モデルを動かすには専用のアプリを使い、代表的なものにOllamaやLM Studioがあります。
| 比べる点 | クラウドのAI(ChatGPTなど) | ローカルLLM |
|---|---|---|
| 入力した文章の行き先 | 事業者のサーバー | 自分のPCの中だけ |
| インターネット接続 | 必要 | 不要(モデルのダウンロード時だけ必要) |
| 賢さ・速さ | 高い(大規模なサーバーで動く) | PCの性能とモデルの大きさしだい |
| 費用 | 無料プランに制限、有料プランは月額 | アプリとモデルは無料のものが多い(PCの費用と電気代はかかる) |
| 安全の管理 | 事業者が管理する | 自分で管理する |
| 手軽さ | アカウントを作ればすぐ使える | アプリとモデルの準備が必要 |
私は、ローカルLLMを「クラウドのAIの代わり」ではなく、「外に出したくない情報を扱うための、もう1つの道具」と見ています。性能や手軽さでは、クラウドのAIのほうが上です。ただ、入力した内容がPCの外に出ないという一点では、ローカルLLMに代わるものはありません。
次の動画では、クラウドのAIとローカルLLMの違いを図で説明したあと、Ollamaのインストールと使い方を実演しています。

ChatGPTなどではプロンプトがクラウドのサーバーに送られて処理されるのに対し、ローカルLLMはモデルを自分のPCにダウンロードして動かす、という違いから説明が始まります。メリットとして、情報が外部に漏れないこと、ネット接続がいらないこと、APIの利用料金がかからないことを挙げています。
生成AIからの情報漏洩はどこで起きている?2023〜2026年の主な事例
生成AIからの情報漏洩は、AIが情報を盗み出すというより、「入力してはいけない情報を入力した」「公開されると思わずに共有した」という、使う側の行動から起きているものがほとんどです。公的な機関も、このリスクを重く見ています。
IPA(情報処理推進機構)が2026年1月29日に発表した「情報セキュリティ10大脅威 2026」では、組織向けの3位に「AIの利用をめぐるサイバーリスク」が初めて入りました。AIへの理解が足りないことによる情報漏えい、生成結果の確認不足、AIを悪用した攻撃の巧妙化などを含む項目です。個人情報保護委員会も2023年6月2日の注意喚起で、生成AIに個人データを含むプロンプトを入力する場合は、事業者がそのデータを機械学習に使わないことなどを十分に確認するよう求めています。
主な事例を表にまとめます。
| 時期 | 何が起きたか | 漏れた経路 |
|---|---|---|
| 2025年夏 | ChatGPTで「検索で見つけられるようにする」を選んで共有した会話が、Google検索に表示された。OpenAIはこの実験を終了 | 共有リンク |
| 2026年7月下旬 | Claudeの共有チャットの一部が、Google検索から読める状態になっていた。共有ページに検索エンジンへの登録を防ぐ指定(noindex)がなかったとみられ、修正された | 共有リンク |
| 2026年8月20日に判明 | RIZAPの担当者が、会社が利用を許可していない外部の生成AIサービスに、特定保健指導の対象者データを入力した。氏名や生年月日に加え、高血圧症・糖尿病・脂質異常症などの疾患情報を含む | 入力(シャドーAI) |
※2026年10月時点
RIZAPの事案は、委託元の健康保険組合や共済組合がそれぞれ対象者数を公表しています。IHIグループ健康保険組合は210名、地方職員共済組合は726名です。委託元の1つは、外部の生成AIに入力・参照されたデータを全体で19,996名分としていますが、これは第三者への流出が確認された人数ではありません。AI事業者からは、データを学習に使っていないとの回答があったと説明されています。
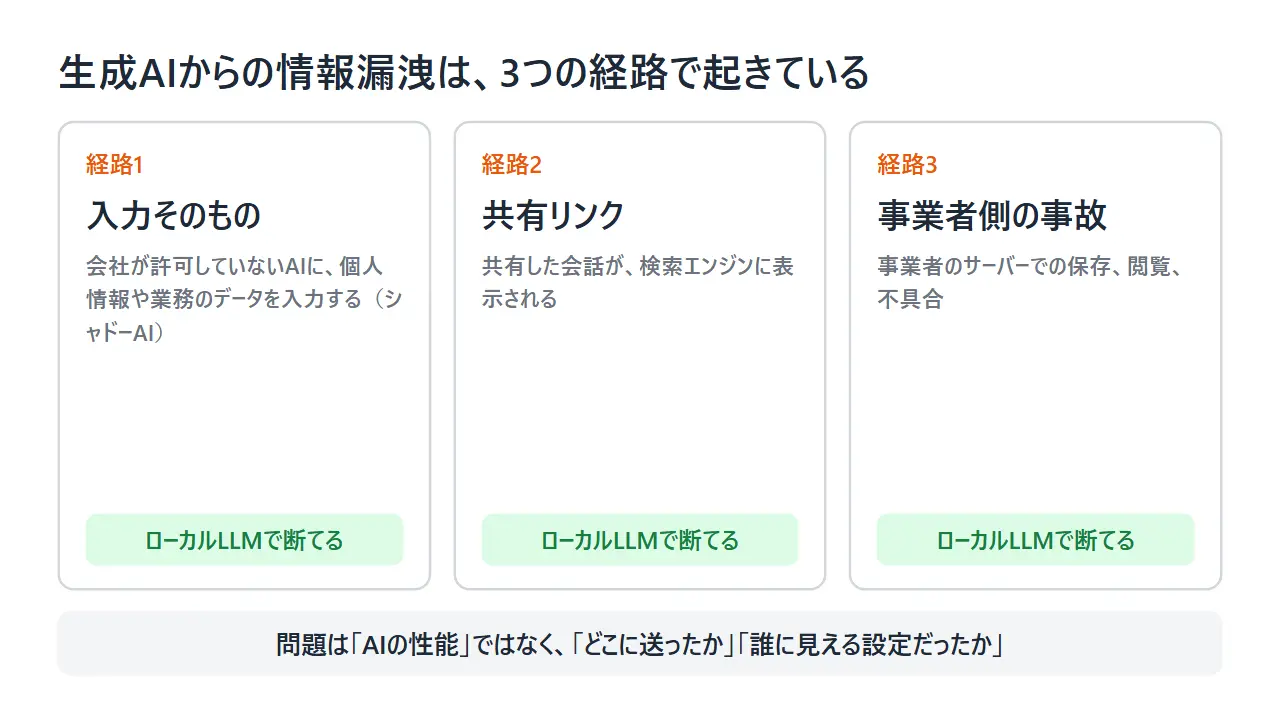
3つの事例に共通するのは、AIの性能ではなく、「どこに送ったか」「誰に見える設定だったか」が問題だった点です。学習に使われなかったとしても、事業者のサーバーに一度送られた情報は、保存され、事業者の担当者が見られる状態になりうる。共有リンクにすれば、検索エンジンに拾われることもある。私は、ここに生成AIの漏洩の本質があると考えています。ローカルLLMは、この問いに「自分のPCの中だけ」と答えられる選択肢です。
攻撃する側も、ローカルLLMを使い始めている
一方で、ローカルLLMは守る側だけの道具ではありません。2026年9月前後から、国内の企業や団体で不正アクセスによる個人情報の漏えいが相次ぎました。パーク24はタイムズカーのWebシステムへの不正アクセスで、約660万アカウントの情報が取得されたと9月28日に発表しています。JPCERT/CCも10月8日に注意喚起を出しました。
この一連の攻撃にAIが使われたかどうかは、2026年10月時点では断定されていません。専門家の共同資料は「AIが使われたと断定できるログや痕跡は確認されていない」とし、別のセキュリティ企業は、人の手とは考えにくいアクセスの量や動きから、AIエージェントによる攻撃の可能性を指摘しています。中国企業が開発したLLMは攻撃の指示をそのまま実行してしまう、と警鐘を鳴らす専門家もいれば、国立情報学研究所の高倉弘喜教授のように、攻撃の自動化にAIは使われたが大きな役割は果たしておらず、主な原因は企業側の対策不足だと見る専門家もいます。
それでも、攻撃者がローカルLLMに目を向ける理由ははっきりしています。クラウドの大手のAIは、危険な依頼を断り、悪用を見つけるとアカウントを止めます。Anthropicは、2025年9月に見つけた国家支援とみられる集団による攻撃でClaude Codeが悪用されていたことを公表し、関係するアカウントを停止しました。手元で動かすオープンウェイトのモデルなら、誰にも見られず、止められることもありません。
- PromptLock: セキュリティ企業ESETが2025年8月に見つけた、ランサムウェアの試作品です。gpt-oss-20bをOllama経由で動かし、ファイルを調べて暗号化するスクリプトをその場で作らせます。大学の研究グループが作った概念実証で、実際の被害は出ていません。
- 安全装置を外したモデル: Anthropicは2026年9月、中国Z.aiのオープンウェイトモデル「GLM-5.3」について、公開されている重みを書き換えれば安全装置を外せると報告しました。約4,400ドル分の計算で、悪意のある依頼を断る割合は9割超から2%まで下がり、公開から数日で安全装置を外した版を公開した開発者もいました。
- 乗っ取られたOllama: 2026年6月12日には、インターネットに公開されたまま認証のないOllamaのサーバーを、攻撃者が攻撃ツールの「頭脳」として使っていたことが確認されています(このときの標的は練習用の環境でした)。
入力した内容を誰にも見られないという性質は、利用者の秘密を守るのと同じように、攻撃者の悪用も隠してしまいます。ローカルLLMは守る道具にも、攻める道具にもなる。この両面を知っておくと、次に説明する「防げること、防げないこと」の意味が見えてきます。
ローカルLLMで防げること、防げないこと
ローカルLLMで防げるのは、入力した内容が外部のAI事業者に渡ることで起きる漏洩です。一方で、使い方や設定を誤れば、ローカルでも情報は漏れます。「ローカルなら漏れない」は、半分だけ正しいと考えてください。
| 漏洩の経路 | ローカルLLMで防げるか | 理由 |
|---|---|---|
| 事業者のサーバーへの保存・学習・閲覧 | 防げる | 文章がPCの外に送られない |
| 共有リンクが検索に表示される | 防げる | 共有の仕組みそのものがない(アプリの共有機能を使わない限り) |
| 事業者側の事故・不具合 | 防げる | 事業者のサーバーを通らない |
| アプリをネットに公開する設定のミス | 防げない | 外から誰でも使え、会話の中身を抜かれることもある |
| クラウドのモデルを選んでしまう | 防げない | アプリによっては、同じ画面からクラウドのモデルも使える |
| 出どころの分からないモデル・アプリ | 防げない | 細工されたものが紛れ込む可能性がある |
| PCの盗難・マルウェア感染 | 防げない | 会話の履歴やファイルはPCの中に残る |
※2026年10月時点
ローカルLLMにすると、クラウドのAIで事業者が担っていた安全の管理が、まるごと自分の手に移ります。私は、ここがいちばん見落とされやすい点だと感じています。外への公開設定、モデルの出どころ、クラウド機能の切り分け、PC自体の管理。この4つを自分で守ることと引き換えに、「外に送らない」安心が手に入る、と考えるのが正確です。
たとえばOllamaは、2025年9月からクラウドで動く「クラウドモデル」も使えるようになりました。Ollamaのプライバシーポリシーでは、ローカルで動かすときは入力を見ないとする一方、クラウドモデルでは入力と回答をOllamaのサーバーで一時的に処理する(学習には使わない)としています。同じOllamaでも、選んだモデルによってはローカルではないということです。
ローカルLLMに必要なPCとモデルの選び方
ローカルLLMの快適さは、PCのメモリ(GPUを使うならVRAM=グラフィックボードのメモリ)と、モデルの大きさの組み合わせで決まります。最初は、手持ちのPCのメモリに余裕を持って収まる、小さめのモデルから試すのが確実です。
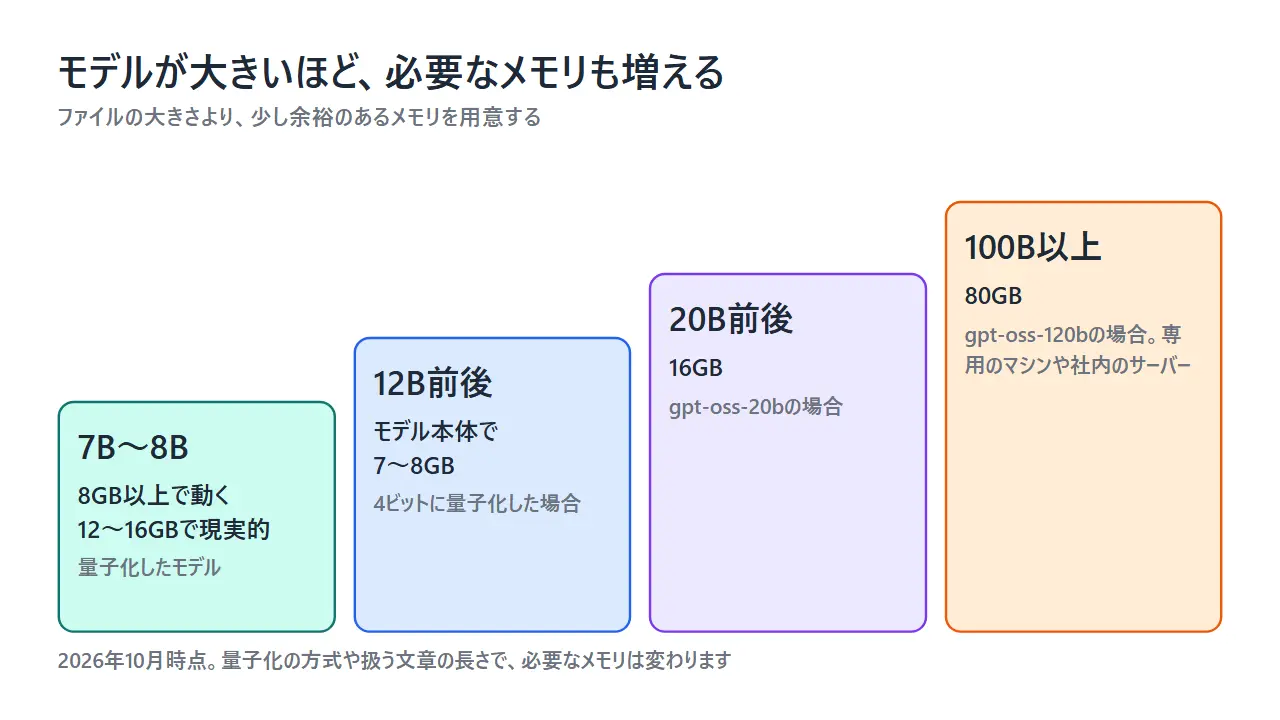
モデルの大きさは、「7B」「20B」のようにパラメータ数(Bは10億)で表します。数字が大きいほど賢くなりやすい一方、必要なメモリも増えます。そのため、モデルを軽くする「量子化」がよく使われます。量子化は、モデルの重みを少ないビット数(4ビットなど)で表して、ファイルの大きさと必要なメモリを減らす技術です。ローカルLLMでよく見る「GGUF」は、量子化したモデルを入れるファイルの形式の1つです。
| モデルの大きさ | 必要なメモリの目安 | 向いているPC |
|---|---|---|
| 7B〜8B(量子化) | 8GB以上で動く。12〜16GBあると現実的 | メモリ16GB前後のPC、GPU付きのPC |
| 12B前後(4ビット) | モデル本体で7〜8GB。16GBのPCなら余裕を見て選ぶ | メモリ16GB以上のPC |
| 20B前後 | gpt-oss-20bは16GB | 高性能な個人のPC |
| 100B以上 | gpt-oss-120bは80GB | 専用のマシン、社内のサーバー |
※2026年10月時点。同じモデルでも、量子化の方式や扱う文章の長さで必要なメモリは変わります
注意したいのは、モデルのファイルの大きさと同じだけのメモリでは足りないことです。モデルの重みのほかに、会話の履歴を覚えておくためのメモリ(KVキャッシュ)が要り、長い文章や長い会話ほど増えます。ぎりぎり収まるモデルを選ぶと、メモリが足りずに動きが極端に遅くなるので、少し余裕を残してください。
代表的なモデルは次のとおりです。
| モデル | 開発元 | 公開 | 特徴 |
|---|---|---|---|
| gpt-oss(20b・120b) | OpenAI | 2025年8月 | Apache 2.0ライセンス。20bは16GBのメモリで動く |
| Gemma 4 | 2026年4月2日 | Apache 2.0ライセンス。小型(E2B・E4B)から31Bまで。画像も扱える | |
| Qwen3.5 | Alibaba | 2026年2月 | オープンウェイトで公開 |
| Qwen3.8-27B | Alibaba | 2026年8月14日 | Apache 2.0ライセンス。画像の入力に対応 |
※2026年10月時点。公開日は各開発元の発表・公開情報をもとにしています
日本語で使うなら、日本語の扱いが得意とされるモデルから選ぶと失敗が少なくなります。仕事で使うときは、ライセンスも確認してください。Apache 2.0のモデルは、商用でも使えます。私は、モデル選びで迷ったら「メモリに余裕を持って収まる中で、いちばん新しい世代のもの」を選ぶのが、いちばん外れが少ないと考えています。
主なアプリの違い(Ollama・LM Studio・Jan・Open WebUI)
ローカルLLMのアプリは、画面で操作したいならLM Studio、コマンドやほかのアプリとの連携を重視するならOllamaが基本の選び方です。社内の何人かで使うなら、ブラウザの画面を用意できるOpen WebUIを組み合わせます。
| アプリ | 操作 | 向いている人 | 気をつける点 |
|---|---|---|---|
| Ollama | インストール後のチャット画面とコマンド | ほかのアプリやプログラムから呼び出したい人 | クラウドモデルも選べる。標準では認証なしでAPIを受け付ける |
| LM Studio | 画面をクリックして操作 | 初めての人、いろいろなモデルを試したい人 | 個人・仕事とも無料。SSOなどは有料のEnterprise |
| Jan | 画面で操作 | 自分の好みや前提を覚えさせて使いたい人 | オンラインのモデルもつなげられる |
| Open WebUI | ブラウザの画面 | 社内向けにChatGPTのような画面を用意したい人 | ローカルとクラウドのモデルを両方つなげられる |
| llama.cpp | コマンド | 細かく設定したい開発者 | 多くのアプリの土台になっている |
※2026年10月時点
LM Studioは、以前は会社で使うには別の商用ライセンスが必要でしたが、その条件をなくし、家庭でも仕事でも無料で使えるようにしました。Open WebUIは、OllamaのほかにOpenAIやAnthropicのモデルにもつなげられ、SSO(シングルサインオン)や操作の記録など、会社で使うための機能もそろっています。
表の「気をつける点」に、ローカルとクラウドを同じ画面で切り替えられる、という項目が並んでいることに注目してください。便利な反面、ローカルのつもりでクラウドのモデルに機密情報を入れてしまう、という事故が起きやすくなります。私は、機密情報を扱うPCでは、クラウドのモデルを最初から使わない設定にしておくのが安全だと考えています。
はじめてのローカルLLM:インストールから最初の質問まで
ローカルLLMは、アプリを入れる→モデルをダウンロードする→質問するの3段階で始められます。ここではOllamaを例に流れを説明します。LM Studioでも、モデルを画面で探してダウンロードする以外は同じ流れです。
- PCのメモリを確かめる: Windowsならタスクマネージャー、Macなら「このMacについて」で、メモリ(GPUがあればVRAM)の容量を確認します。前の節の表で、動かせるモデルの大きさの目安をつけます。
- 公式サイトのダウンロードページを開く: Ollamaの公式サイトのダウンロードページで、macOS・Linux・Windowsから自分のOSを選びます。配布元を間違えないよう、検索広告や配布サイトではなく、公式サイトから入れてください。
- インストールする: ページに表示されるコマンドをコピーしてWindowsなら PowerShell に貼り付けて実行するか、「Download manually」からインストーラーをダウンロードして、画面の指示に従ってインストールします。Ollamaは、インストールが終わるとチャットの画面が開きます。
- モデルをダウンロードする: チャット画面でモデルを選ぶか、コマンドで
ollama run <モデル名>と入力すると、モデルのダウンロードが始まります。数GBあるので、時間に余裕を持って行います。モデル名の末尾が「-cloud」のものはクラウドモデルなので、ローカルで使いたいときは選びません。 - 質問してみる: ダウンロードが終われば、すぐに質問できます。試しにWi-Fiを切ってから質問し、答えが返ってくれば、PCの中だけで動いていることを確かめられます。
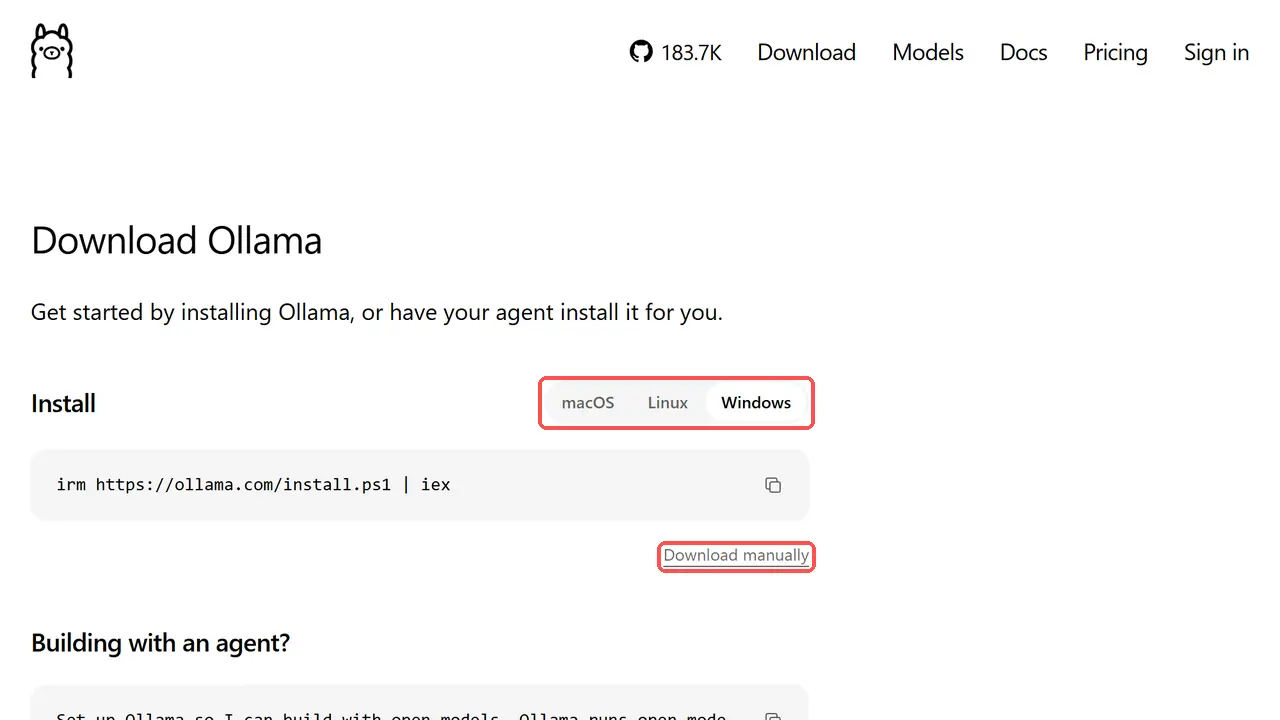
インストールから実際の質問までの流れは、次の動画が分かりやすく見せています。

公式サイトの右上の「Download」から、macOS・Linux・Windowsの版を選んでインストールする手順を、画面とともに説明しています。クラウドのAIとの違い(プライバシー、ネット環境、処理速度、料金)の整理や、必要なスペックの考え方、実際にモデルを入れて質問する様子まで1本で確認できます。
最初の質問は、答えの正しさを自分で判断できる内容にしてください。ローカルLLMの答えは、クラウドの大きなモデルより間違いが多くなりがちです。私は、まず手元にある公開して困らない文章の要約や言い換えで試し、満足できる答えが返ってきてから、社外に出せない資料に広げていくのがよいと考えています。
ローカルでも漏れる?安全に使うための5つの確認
ローカルLLMを安全に使うために、最初に確かめたいのは「アプリを外に公開していないか」です。手間が少なく効果が大きい順に、5つの確認を挙げます。
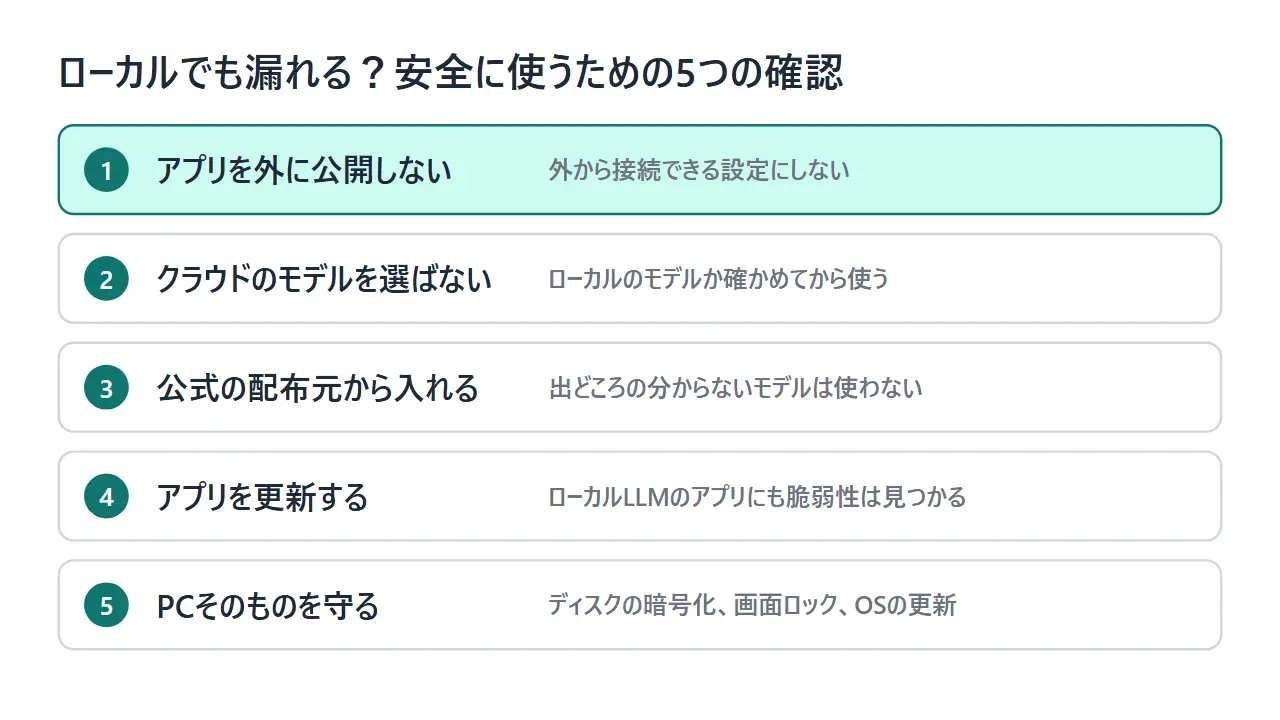
- アプリを外に公開しない: Ollamaは、標準ではAPIに認証がありません。外部から接続できる設定にすると、誰でもモデルを使え、会話の中身を抜かれることもあります。Ciscoは、インターネットに公開されたOllamaのサーバーを1,139台見つけ、そのうち214台は実際にモデルを読み込んで応答していました。別の調査では、認証のないまま公開されているOllamaは約17万5,000に上るとされています。自分のPCの中だけで使うなら、外からの接続を許す設定は変えないでください。
- クラウドのモデルを選ばない: 同じアプリの中に、クラウドで動くモデルが並んでいることがあります。機密情報を扱うときは、モデル名や説明でローカルのモデルであることを確かめてから使います。
- 公式の配布元から入れる: アプリは公式サイトから、モデルは開発元や信頼できる配布元から入れます。安全装置を外したモデルや、出どころの分からないモデルには、細工が仕込まれている可能性があります。
- アプリを更新する: ローカルLLMのアプリにも脆弱性は見つかります。2026年5月には、Ollamaで、認証なしにメモリの中のAPIキーや会話のデータを抜き出せる脆弱性(CVE-2026-7482)が公表されました。更新の通知が出たら、早めに入れてください。
- PCそのものを守る: 会話の履歴や読み込ませたファイルは、PCの中に残ります。ディスクの暗号化、画面ロック、OSとセキュリティソフトの更新は、ローカルLLMを使うなら欠かせません。
1番目を最初に置いたのは、効果に対して手間がほとんどかからないからです。初期の設定のまま、自分のPCの中だけで使っていれば守られます。逆に、「スマホから使いたい」「同僚にも使わせたい」と設定を変えたとたん、PCの中だけという前提が崩れます。外から使う必要が出たときは、VPNの内側に置くなど、詳しい人と相談してから設定を変えるのが確実です。
会社で使うときの考え方:クラウドとローカルの使い分け
会社でローカルLLMを使うときは、「全部ローカルにする」か「全部クラウドにする」かではなく、扱う情報の重さで使い分けるのが基本です。性能と手軽さはクラウド、機密性はローカル、という特性はどちらも変わらないからです。
| 扱う情報 | 向いている使い方 |
|---|---|
| 公開されている情報、一般的な質問、アイデア出し | クラウドのAI(学習に使わない設定を確認したうえで) |
| 社内の資料、取引先の情報 | 会社が契約したクラウドのAI(入力を学習に使わない契約のもの)か、ローカルLLM |
| 個人情報、健康や病気の情報、未公開の財務情報 | ローカルLLM(社内のサーバーやネットにつながないPC) |
RIZAPの事案で問題になったのは、会社が利用を許可していないAIサービスに、社員が個人で業務のデータを入力したことでした。こうした「シャドーAI」は、禁止するだけでは防ぎきれません。社員がAIを使いたい理由は、仕事を早く終わらせたいという前向きなものだからです。
私は、会社が安全に使える道具を先に用意することが、シャドーAIへのいちばんの対策だと考えています。機密情報を扱う部署には社内のサーバーで動くローカルLLMを、それ以外には入力を学習に使わない契約のクラウドのAIを用意し、「この情報はこちらに」と線を引いておく。そうすれば、社員が個人のアカウントに頼る理由がなくなります。
よくある質問
ローカルLLMなら情報漏洩は絶対に起きませんか?
絶対ではありません。ローカルLLMで防げるのは、入力した内容が外部のAI事業者に渡ることによる漏洩です。アプリを外に公開する設定のミス、クラウドのモデルの選択、細工されたモデル、PCの盗難やマルウェア感染では、ローカルでも漏れることがあります。
ローカルLLMを動かすにはどのくらいのスペックのPCが必要ですか?
7B〜8Bの量子化したモデルなら、メモリ(VRAM)8GB以上で動き、12〜16GBあると現実的に使えます。20B前後のモデルでは16GB以上が目安です。モデルのファイルの大きさより、少し余裕のあるメモリを用意してください。
ローカルLLMはChatGPTと比べて性能はどのくらいですか?
一般的なPCで動く大きさのモデルは、クラウドの最上位のAIには及びません。答えの速さもPCの性能しだいです。ただし、gpt-oss-20bのように、16GBのメモリで動きながら、OpenAIの小型の推論モデルに近い成績を出すモデルもあります。
ローカルLLMは無料で使えますか?会社で使っても大丈夫ですか?
OllamaやLM Studioなどのアプリと、多くのオープンウェイトのモデルは無料です。LM Studioは仕事でも無料で使えます。会社で使うときは、モデルのライセンス(Apache 2.0なら商用も可)と、社内のルールを確認してください。
ChatGPTなどに入力した内容は学習に使われますか?使わせない方法はありますか?
サービスやプラン、設定によって変わります。多くのサービスには、入力を学習に使わない設定や、学習に使わない法人向けの契約があります。ただし、学習に使われなくても、入力した内容は事業者のサーバーに送られるため、外に出したくない情報はローカルLLMで扱うのが確実です。
「どこに送るか」を自分で決められるようにするために
最後に、この記事のポイントを振り返ります。
- ローカルLLMは、AIを自分のPCの中だけで動かし、入力した内容を外部の事業者に送らない使い方
- 生成AIからの漏洩の多くは、「どこに送ったか」「誰に見える設定だったか」から起きている
- ローカルLLMは守る道具にも攻める道具にもなり、ローカルにすると安全の管理は自分の手に移る
- 必要なPCは、メモリの容量とモデルの大きさの組み合わせで決まる。まずは小さめのモデルから
- 安全に使うには、外に公開しない、クラウドのモデルを選ばない、公式の配布元から入れる、更新する、PCを守る
生成AIを使うかどうかではなく、どの情報をどこに送るかを自分で決めることが、これからのAIとの付き合い方の基本になると私は考えています。まずは自分のPCのメモリの容量を確かめて、Ollamaか LM Studioで小さなモデルを1つ動かしてみてください。Wi-Fiを切っても答えが返ってくるのを見ると、「PCの中だけで動く」という意味が実感できるはずです。