「Jevというチャットしない新しいAIが話題らしい」と聞いて、検索してみた人も多いのではないでしょうか。ChatGPTのように話しかけられないなら、何に使うのか。「LLMより193倍速い」「幻覚ゼロ」といった強い言葉は、どこまで本当なのか。日本から使えるのか。気になる点はいくつもあるはずです。
この記事では、Jevの仕組み、ChatGPTとの違い、3つの答え方、料金、数字の読み方、試し方、注意点までを1本で説明します。読み終えるころには、自分の仕事のどの判断をJevに任せられそうかを、1つ書き出せるはずです。内容は2026年10月時点で、開発元の公式サイトと公式ドキュメントを確かめ、2026年10月15日に私が実際に登録した画面も使っています。
Jev(ジェヴ)とは、文章を書かずに「判断」だけを返すAI
Jev(ジェヴ)は、米国のTypeSafe AIが作った、文章を書かずに「判断」だけを返すAIモデルです。「はい/いいえ」「候補から選ぶ」「段階で採点する」のように、答えの形をあらかじめ決めて質問すると、その形の答えを確率付きで返します。
TypeSafe AIは2026年9月15日にJevを発表し、この種類のモデルを「System One Model」と呼んでいます。ChatGPTのようなLLM(大規模言語モデル)が人と話すために作られたのに対し、Jevはソフトウェアの中で使われることを前提にしています。開発元は、Jevを「賢いif文(Smart if-statements)」と説明しています。読み方の「ジェヴ」は、日本で試せる環境を公開したGMO天秤AIの表記です。TypeSafe AIは、2026年10月時点で公式の読み方を示していません。
基本の情報を表にまとめます。
| 項目 | 内容 |
|---|---|
| 読み方 | ジェヴ(GMO天秤AIの表記。公式の読み方は示されていない) |
| 開発元 | TypeSafe AI(米国サンフランシスコ) |
| 発表 | 2026年9月15日 |
| モデルの種類 | System One Model(判断だけを返すAI) |
| 答えの形 | Choice(選ぶ)、Score(採点する)、Noul(はい/いいえの確率)。実験機能として位置を返す box |
| 応答の速さ | 70〜500ミリ秒(開発元の説明) |
| 速さ・安さの倍率(開発元の主張) | 公式ブログ: 判断の作業でLLMの40〜200倍速い/公式サイト: 社内のワークフロー評価で最大193.6倍速く、444.6倍安い/コンソールの紹介画面: 20〜200倍速く、40〜1,000倍安い |
| 料金 | 入力100万トークンあたり0.042ドル(10億トークンあたり42ドル)。出力は無料 |
| 版 | jev-1.14.0(2026年10月14日公開。jev-preview で提供) |
| 入力 | テキスト。画像は実験機能(2026年10月14日から) |
| 選択肢の数 | 1つの質問で255個まで |
| 1回に渡せる量 | 状態と質問を合わせて約32,000トークン |
| 使い始め方 | 公式のコンソール(2026年10月15日はウェイトリストなしで登録できた)、Vercel AI Gateway、Netlify AI Gateway、GMO天秤AIのお試し環境 |
※ 表の内容は2026年10月時点のものです。
表で目を引くのは、出力が無料という料金の仕組みです。文章を書かないので、答えの分の料金がかからないという考え方です。私は、Jevを「ChatGPTより賢いAI」ではなく、「仕事の中の小さな判断を、速く安く大量にこなす部品」と見ています。この見方で読むと、ここから先の説明がすっきり入ってくるはずです。
Jevを作ったTypeSafe AIは、どんな会社か
TypeSafe AIは、米国サンフランシスコのAI企業です。創業者でCEOのディオゴ・アルメイダ(Diogo Almeida)氏は、OpenAIで、ChatGPTの土台になった研究(RLHF)に関わった人物です。
TypeSafe AIは2年間、存在を伏せて開発を続け、2026年9月15日にJevと一緒に表に出ました。同じ日に、ベンチャーキャピタルのDCVCが主導する4,000万ドルのシード調達も発表しています。共同創業者は、CTOのエリック・ガフニ(Erik Gafni)氏と、COOのサーシャ・シェン(Sasha Sheng)氏です。
アルメイダ氏は公式ブログで、チャットのAIは何年も前から人間並み以上に会話できるのに、仕事の自動化は進んでいない、という問いから出発したと書いています。名前の由来も公式ブログにあります。
- System One Model: 心理学者ダニエル・カーネマンの『ファスト&スロー』の、速い直感の思考(System 1)と、ゆっくり考える思考(System 2)の区別から
- Jev: 経済学者ウィリアム・スタンレー・ジェヴォンズから。石炭を使う効率が上がると、かえって石炭の需要が増えたように、AIが安くなると使い道が何桁も増える、という見立てを込めている
発表から1か月足らずで、会社の規模は大きく変わりました。2026年10月9日には、約8億7,000万ドルを評価額75億ドルで調達したと、米国の経済メディアが報じています(会社の発表は、2026年10月時点で見つけられていません)。会社は、Jevの利用者が100万人を超え、米国の大企業500社(Fortune 500)の約3分の1が使っていると説明していますが、企業の名前は明かしていません。
私は、「ChatGPTを作った側の人が、チャットではない方向に賭けた」という点に、この会社のいちばんの特徴があると見ています。
ChatGPTなどのLLMと何が違うのか
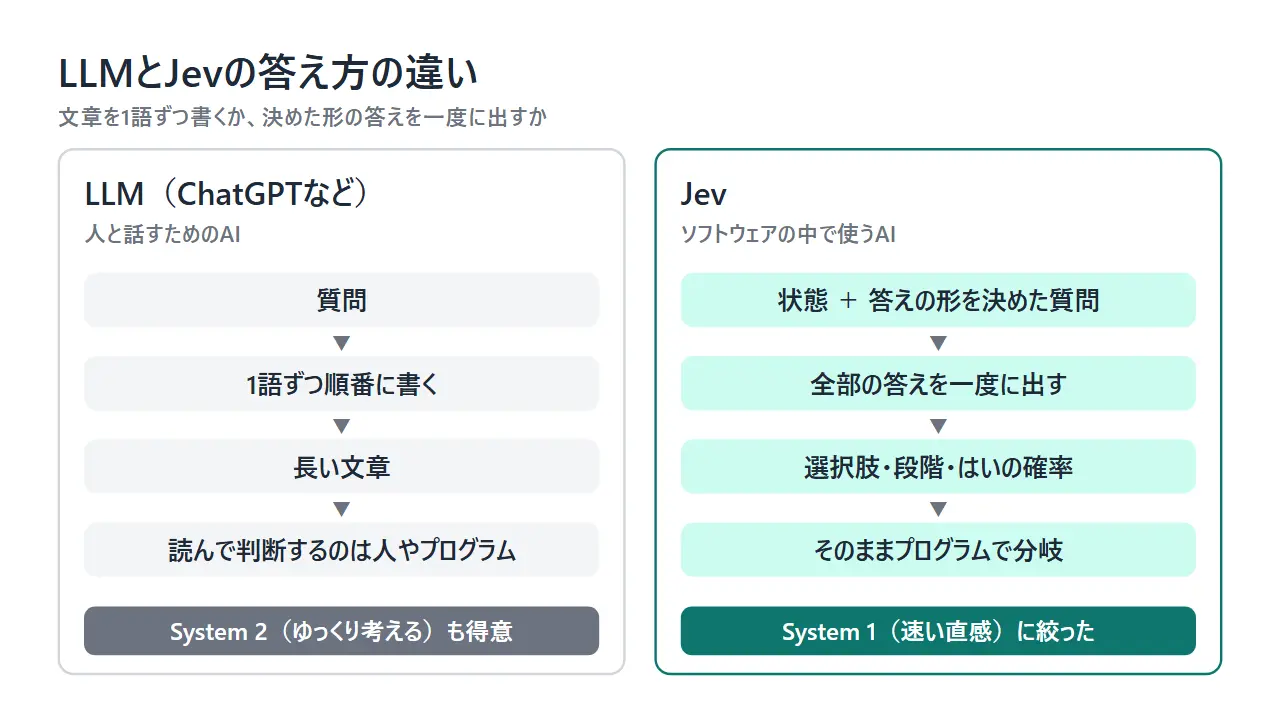
いちばん大きな違いは、LLMが文章を1語ずつ書くのに対して、Jevは答えの範囲を先に決めて、全部の答えを一度に出すことです。この違いが、速さ、安さ、答えの形が崩れないことにつながっています。
ChatGPTやClaudeのようなLLMは、前の語に続く語を1つずつ選んで文章を作ります。自由に書けるので、説明もコードも書けますが、長い答えほど時間がかかり、出力の分の料金もかかります。プログラムの中で使うときは、返ってきた文章を読み取り、形が正しいかを確かめる手間も要ります。
Jevは、出てくる答えの形を質問の側で決めます。「はい/いいえ」なら確率を、「選ぶ」なら決めた候補のどれかを返し、それ以外は返しません。公式ブログは、1回の問い合わせで全部の答えを並列に出すと説明しています。公式ドキュメントでは、1回の呼び出しにたくさんの質問を入れても、応答の時間はほとんど変わらないとしています。
公式ブログの比べ方を、要点だけ表にします。
| 比べる点 | LLM(ChatGPTなど) | Jev |
|---|---|---|
| 鍛え方 | 人が好む答えを学ぶ(RLHF)など | 確率が正直な判断を学ぶ(RLCD) |
| 答えの形 | 文章(何でも書ける) | 先に決めた形の値だけ |
| 答えの出し方 | 1語ずつ順番に | 全部を一度に |
| 確信の伝え方 | 頼んでも自信過剰になりやすい | すべての答えに確率が付く |
| 向いている仕事 | 人と話す、文章やコードを書く | 振り分け、採点、確認、ガードレール |
※ 表の内容は2026年10月時点の開発元の説明によるものです。
LLMの速い直感(System 1)にあたる部分だけを取り出し、文章を書く力を手放した代わりに速さを得た、と考えると分かりやすいと思います。私は、「どちらが賢いか」で比べるより、「文章を書く仕事はLLM、はい/いいえや振り分けの仕事はJev」と役割で分けるほうが、使いどころが見えると考えています。
Jevの3つの答え方:選ぶ・採点する・はい/いいえ
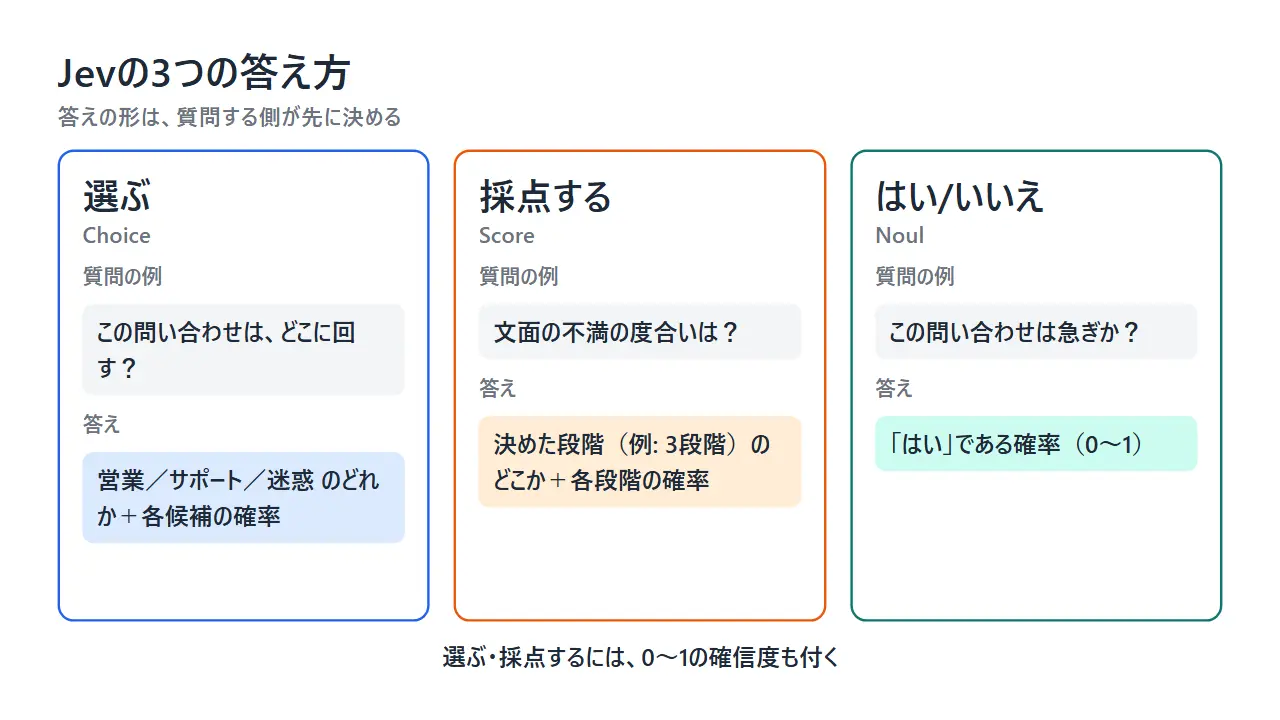
Jevへの質問には、答えの形が3種類あります。選ぶ(Choice)、採点する(Score)、はい/いいえの確率(Noul)です。どれも、答えに確率が付いて返ってきます。
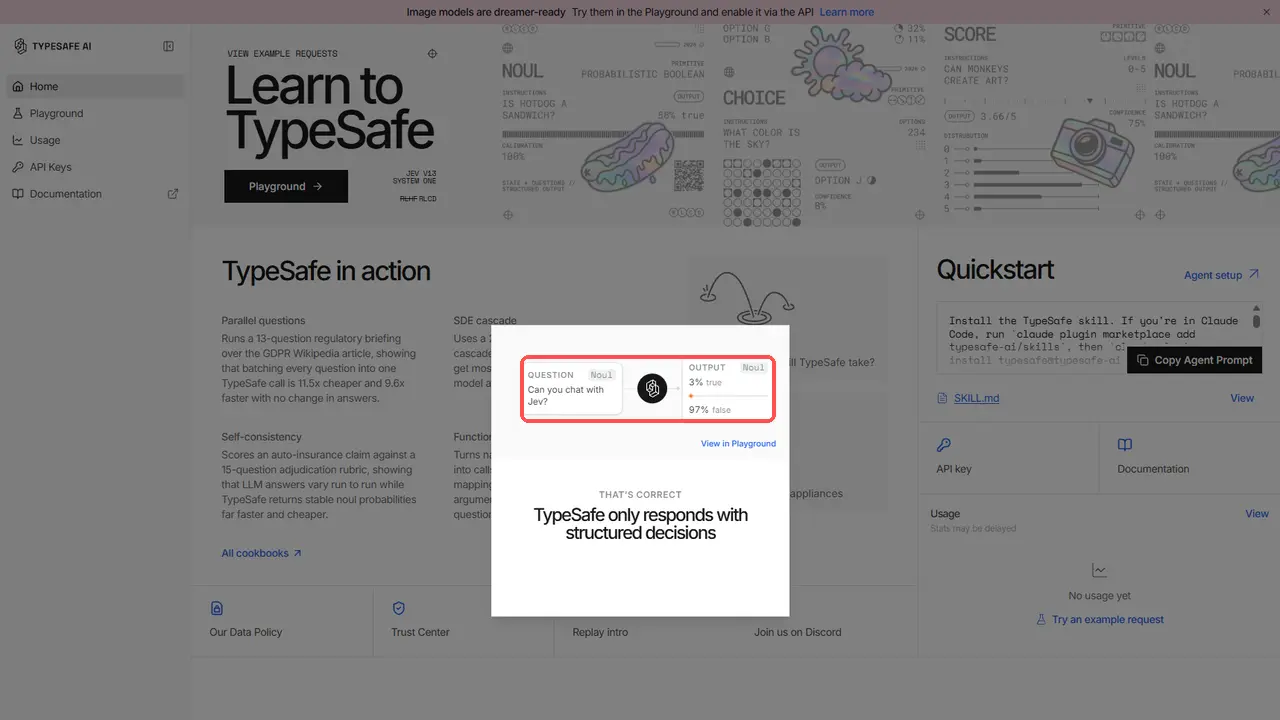
私がコンソールに初めて入ったとき、最初に出てきたのは小テストでした。「Jevとチャットできる?」という問いに「はい」を選ぶと不正解で、「TypeSafeは構造化された判断だけを返す」と出ます。正解の画面では、同じ問いをNoulでJevに聞いた例として、「3% true/97% false」が表示されていました。Jevが自分で「チャットはできない」と確率で答えている、という作りです。
3つの答え方を、公式ドキュメントの名前と並べて整理します。
| 答え方 | 公式の名前 | 返ってくるもの | 使う場面の例 |
|---|---|---|---|
| 選ぶ | Choice | 候補のうち1つと、各候補の確率、確信度 | 問い合わせを営業・サポート・迷惑のどれに回すか |
| 採点する | Score | 決めた段階のどこか(2〜10段階)と、各段階の確率、確信度 | 文面の不満の度合いを3段階で採点 |
| はい/いいえ | Noul | 「はい」である確率(0〜1) | この問い合わせは急ぎか |
※ 表の内容は2026年10月時点のものです。
「Noul」は耳慣れない名前ですが、開発元のAPIでの呼び名です。Vercelの開発用ライブラリ(AI SDK)では、同じものを「boolean」と呼んでいます。
公式ドキュメントが勧めているのは、1つの質問では1つのことだけを聞き、複雑な判断は小さな質問に分けて、コードで組み合わせる使い方です。たとえば「この事業計画を採点して」と1問で聞くのではなく、市場の大きさ、作れるか、他との違いを別々に採点し、点数の重みは自分のコードで決めます。重みを変えたいときは、質問の文ではなくコードの数字を変えればよい、という考え方です。
私は、この「質問を小さく分ける」発想が、Jevを使いこなせるかどうかの分かれ目だと見ています。LLMに長い指示を書いて全部を任せるのとは、頭の使い方が逆だからです。
確信度で「機械に任せる判断」と「人が見る判断」を分ける
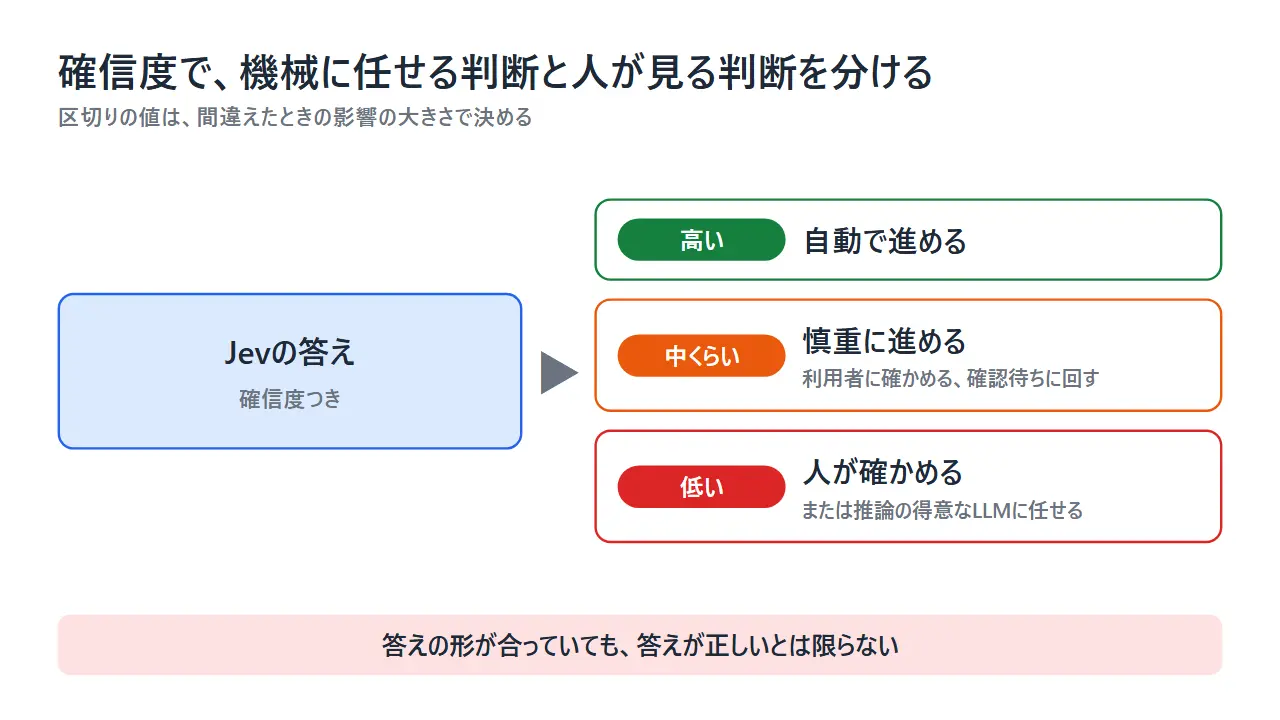
Jevの答えには、どれくらい自信があるかを示す確信度が付きます。この数字で、自信の高い判断は自動で進め、低いものだけを人に回すのが、Jevの使い方の基本です。
公式ドキュメントでは、選ぶ(Choice)と採点する(Score)の答えに、0〜1の確信度が付きます。確率が1つの答えに集まっていれば1に近く、候補にばらけていれば0に近くなります。はい/いいえ(Noul)には別の確信度は付かず、確率そのものが目安です。0.5に近いほど、Jevが迷っているという意味になります。
公式ドキュメントは、確信度を3つの範囲に分ける使い方を、出発点として紹介しています。
- 高い: そのまま自動で進める
- 中くらい: 進めるが、利用者に確かめる、確認待ちに回す、情報を足すなど、慎重に扱う
- 低い: 動かさない。人に回すか、別の仕組み(推論の得意なLLMなど)に任せる
区切りの値は1つではありません。間違えたときの影響が大きい操作ほど、高い確信度を求めるべきだとしています。公式ドキュメントは、最初は慎重な値から始め、自分のデータで試しながら調整するよう勧めています。
開発元は、Jevの確率は「当たる割合と合うように鍛えている」と説明しています。ただし、それは多くの答えをまとめて見たときの話で、1つ1つの答えが正しいことを保証するものではない、とも公式ドキュメントに書かれています。私は、Jevの価値は「間違えないこと」よりも、「自信がないときに、自信がないと言えること」にあると考えています。人が確かめる件数を減らしつつ、迷う案件だけを拾えれば、仕事の自動化はぐっと現実的になります。
Jevでできること・苦手なこと
Jevが得意なのは、振り分け、分類、採点、確認のように、答えの範囲が決まった判断をたくさん、速くこなすことです。反対に、文章を書くこと、じっくり考える推論、専門分野の深い知識は苦手です。
開発元が挙げている使い方は、次のとおりです。
- 仕事の流れの中の判断: 問い合わせの振り分け、書類の種類の判定、請求書を払うか保留するかの判断
- 大量のデータの下ごしらえ: たくさんの文章に、同じ質問をまとめてかけて特徴を取り出す
- リアルタイムの用途: 0.1秒前後の速さを生かして、画面の操作に合わせて判断する
- ほかのAIの確認: LLMの答えや作業の記録を採点する、決まりを外れていないかを見張る(ガードレール)
公式ブログでは、ゲームの『DOOM』を、Jevへの問い合わせを1秒に10回送って遊ばせるデモも紹介しています。費用は1時間あたり約7ドルだったそうです。ただし、ゲームの画面ではなく、ゲームの状態を文字のデータにして渡しています。
実際の導入例として、開発元は、AIで人材を紹介するJack & Jillの事例を公開しています。候補者の最初の選別をGeminiの軽いモデルからJevに替え、選別の質を保ったまま、費用を88%減らし、かかる時間をほぼ半分にしたという内容です。開発元が公開した事例なので、ほかの会社で同じ結果になるとは限りません。
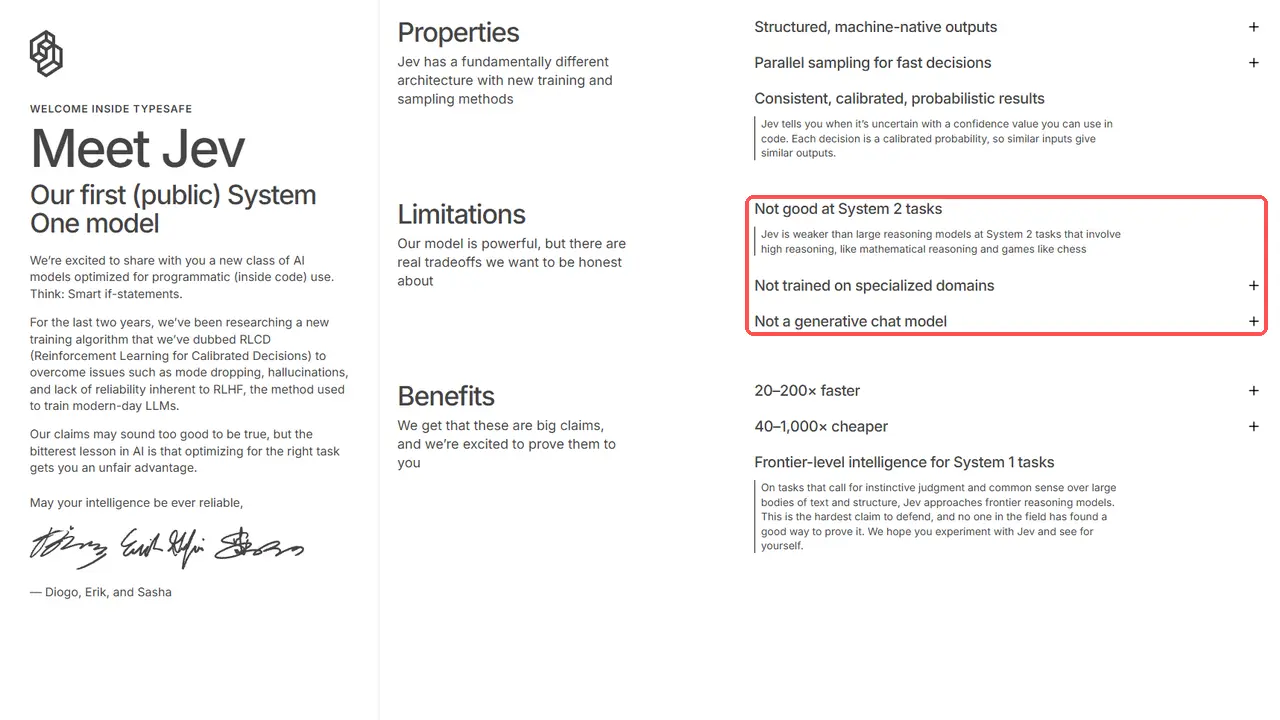
苦手なことは、開発元が自分で書いています。私が登録したときに表示された紹介画面には、次の3つが並んでいました。
- System 2の作業は弱い: 数学の推論やチェスのように、深く考える作業は、大規模な推論モデルにかなわない
- 専門分野で鍛えていない: 専門の深い知識は持っていない(必要な情報を渡せば、それをもとに判断はできる)
- チャットのモデルではない: 会話はできない。答えの形を先に決めて聞く必要があり、選択式の問題を作るのに近い
公式ドキュメントは、深く考えたり、いくつもの要素を比べたりする必要がある質問は分けるよう勧めています。報道によれば、数を正確に数える、日付を比べる、計算するといった作業は、コードに任せたほうがよいとされています。私は、判断のうち「ルールで書けるところはコード、人なら数秒で決められるところはJev、じっくり考えるところはLLMか人」と3つに分けると、Jevの置き場所がはっきりすると考えています。
「193倍速い」「幻覚ゼロ」はどういう意味か
「193倍速い」は、開発元が自分で作ったワークフロー評価での、いちばん良い値です。「幻覚ゼロ」は、答えの形が決めたとおりになるという意味で、答えが必ず正しいという意味ではありません。どちらも開発元の言い方なので、数字に飛びつかずに読む必要があります。
速さと安さの倍率は、開発元の中でも3通りあります。
- 公式ブログ: 判断の作業で、LLMの40〜200倍速い
- 公式サイト: 社内のワークフロー評価で、最大193.6倍速く、444.6倍安い
- コンソールの紹介画面: 20〜200倍速く、40〜1,000倍安い
この記事では、幅で「LLMより数十倍〜200倍ほど速い」と書くことにしています。
193.6倍の出どころは、開発元のワークフロー評価です。セキュリティの警告、AIエージェントの作業記録、請求書の処理、カスタマーサポートの4つの仕事を、同じ流れ(ワークフロー)で各社のモデルに解かせ、OpenAIのGPT-6 AstraとAnthropicのFable 5.1の平均の答えを「正解」として比べています。
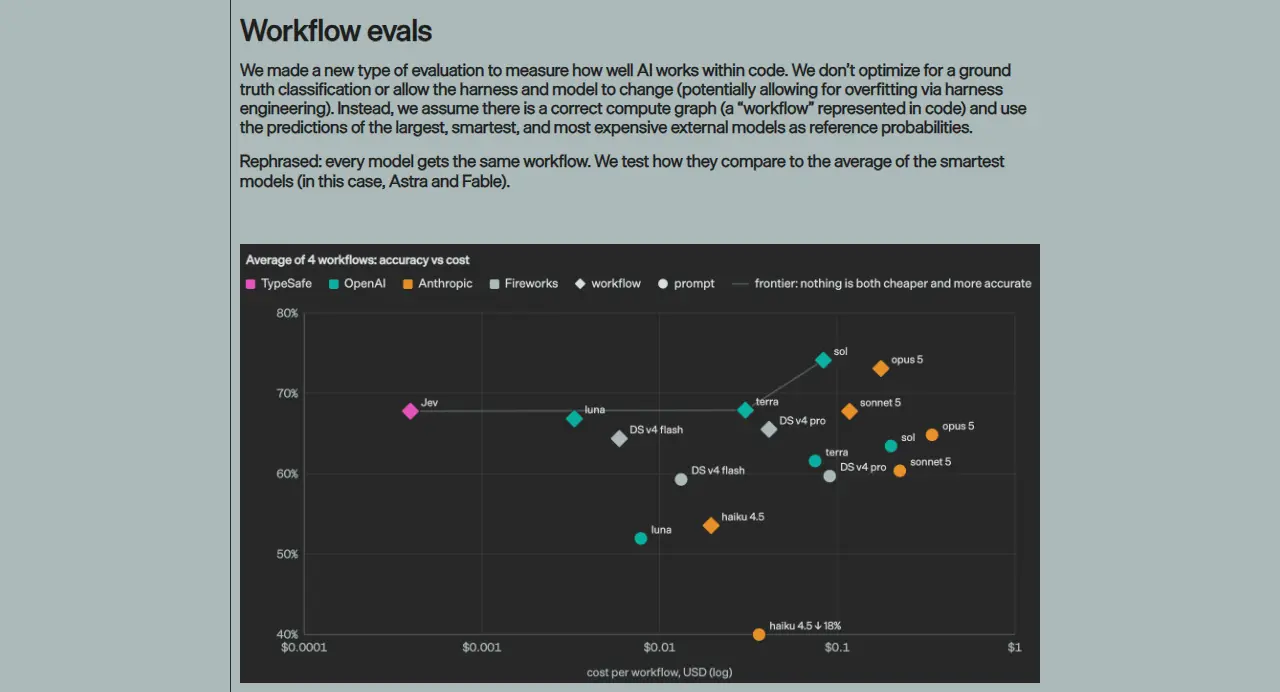
公式ブログは、この評価の限界を自分で書いています。
- 193.6倍・444.6倍は、実際の仕事で得られる効果の上のほうの値と見ている
- 評価の課題は、開発元のチームの人が作ったので、偏りがあるかもしれない
- 正解をGPT-6 AstraとFable 5.1の平均にしているので、その2社のモデルに有利な比べ方になっている
- 速さは、主に米国西海岸のノートPCから測っている(サービスも西海岸にある)
- 料金が補助金で安くなっていないことは証明できない。続くかどうかは、長い目で示すしかない
「幻覚ゼロ(Zero Hallucinations)」も、公式ブログの注記を読むと意味がはっきりします。グラフのJevの0%は、測った値ではなく、答えの形が必ず決めたとおりになるので0%と書いた、と説明されています。決めた候補の外の答えや、存在しないツールの名前は返ってきません。ただし、決めた候補の中で間違った答えを選ぶことはあります。
私は、こうした但し書きを開発元が自分で並べている点は、むしろ信頼できると感じました。そのうえで、数字は「自分の仕事で試す価値がありそうだ」という目安にとどめ、確信度の低い答えを人に回す形で、小さく試して確かめるのがよいと考えています。
Jevの始め方・試し方
Jevを試す方法は、大きく3つあります。登録なしで気軽に試すならGMO天秤AIのお試し環境、Jevそのものを触るならTypeSafe AIのコンソール、開発に組み込むならAPIかVercel・Netlifyの仕組みです。
GMO天秤AIのお試し環境で試す
いちばん手軽なのは、GMO天秤AIが2026年9月28日に公開したJevのお試し環境です。2026年10月15日に開いたときは、ログインしなくてもページが開き、サンプルのアプリが並んでいました。
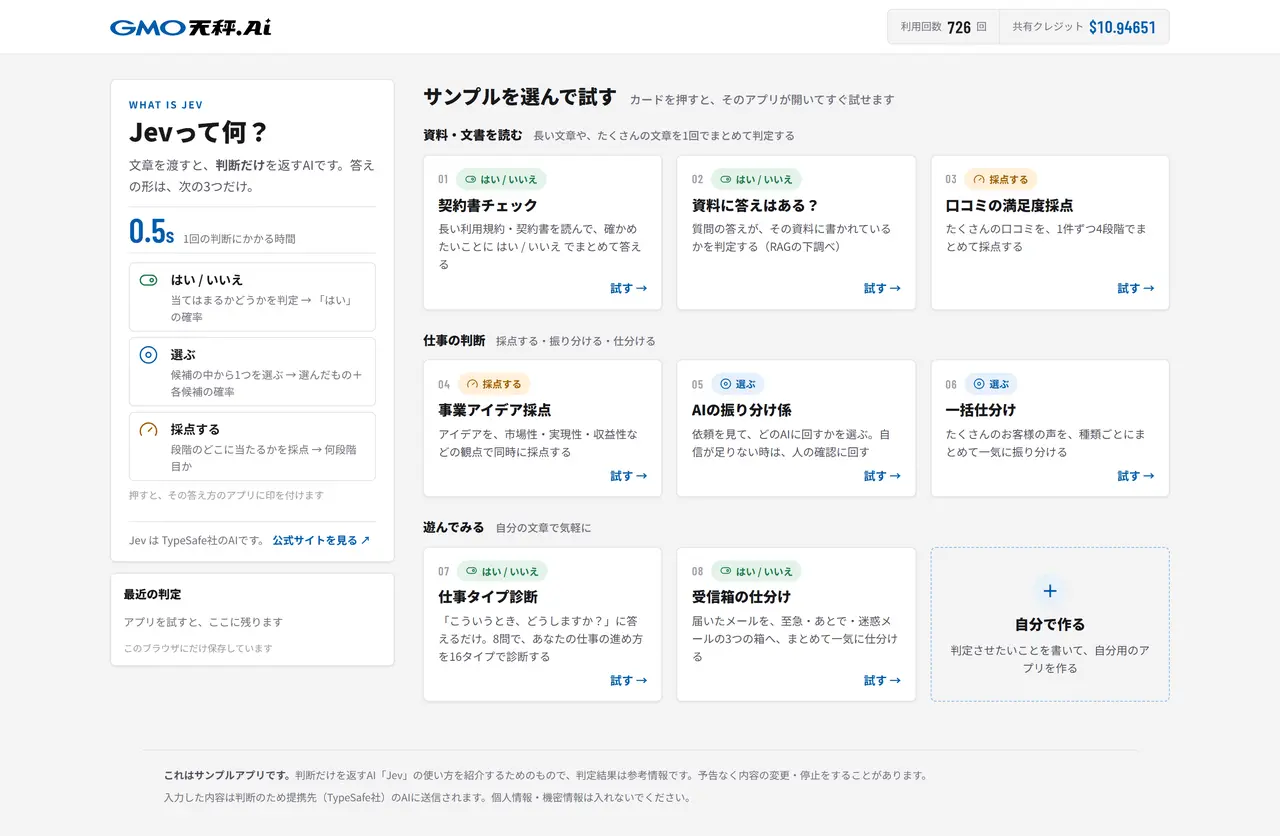
サンプルは8種類で、ほかに「自分で作る」もあります。
- はい/いいえ: 契約書チェック、資料に答えはある?、仕事タイプ診断、受信箱の仕分け
- 採点する: 口コミの満足度採点、事業アイデア採点
- 選ぶ: AIの振り分け係、一括仕分け
画面の上には、利用回数と、みんなで使う「共有クレジット」の残りが表示されていました。GMO天秤AIは、内容を予告なく変えたり止めたりする場合があると書いています。また、入力した内容はTypeSafe AIのAIに送られるので、個人情報や社外秘の情報は入れないでください。
TypeSafe AIのコンソールに登録する
Jevそのものを触るなら、TypeSafe AIのコンソールに登録します。私が2026年10月15日に試したときは、日本から、ウェイトリストなしで登録できました。手順は次のとおりです。
- コンソールを開き、「Continue with Google」を押すか、メールアドレスを入れて「Continue」を押す
- メールで始めた場合は、届いたメールのリンクを押して入る(届かなければ、迷惑メールのフォルダも見る)
- 利用規約とプライバシーポリシーに同意する。お知らせのメールを受け取る設定は、初めからオンになっている
- 「自分のこと」「組織」「知ったきっかけ」の3つの質問に答える。どれも「Skip」で飛ばせる
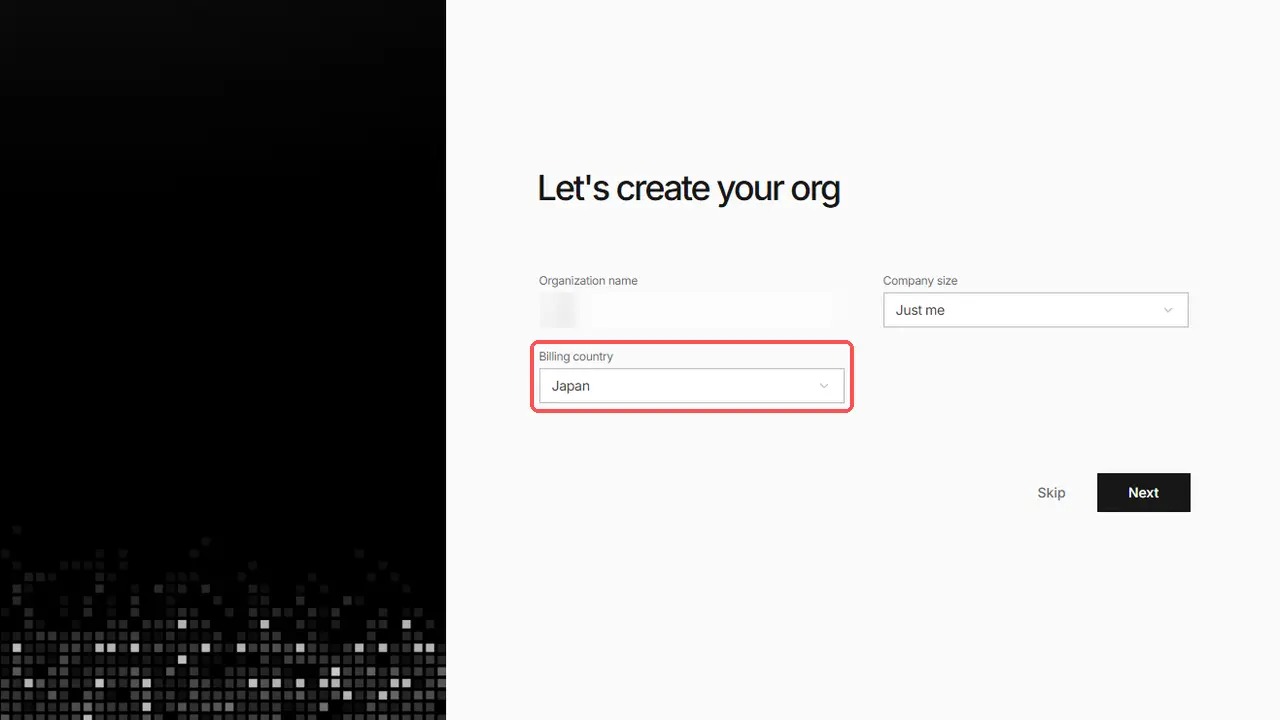
- 組織の画面では、組織名、会社の規模(1人なら「Just me」)、請求先の国を入れる。請求先の国は、初めは米国(United States of America)になっているので、日本(Japan)に変える
入るとすぐに「Meet Jev」という紹介画面が出て、長所と短所を開いて読めます。その後のホーム画面には、Playground(ブラウザで試す画面)、使い方の例、APIキー、ドキュメントへの入口が並んでいます。登録した直後の残高は0ドルでした。
受付の状況は変わりやすいので注意してください。発表の直後はウェイトリストで順番に招待する形で、2026年9月20日に誰でも登録できるようになった後、2日足らずで新規登録を一時止めた時期がありました。
Playgroundで練習問題を解いてみた
コンソールのPlaygroundには、練習問題がついています。私は、残高0ドルのまま「ホットドッグはサンドイッチか?」というはい/いいえ(Noul)の練習を最後まで進めました。
- 質問を入れて、答えの形を「noul」にして実行すると、58%が「はい」。案内には「モデルはかなり迷っている。サンドイッチの定義を足そう」と出る
- 「サンドイッチとは、パンなどの間に具を挟んだ料理」「パン1枚だけ、トルティーヤやクッキーで包んだものは違う」という基準(criteria)を足して実行すると、76%に上がった
- 状態(State)の欄に「アイスクリームサンド」とその説明を書き、質問のhotdogを参照に置き換えて実行すると、33%。案内は「名前にサンドイッチと付いていても、だまされなかった」
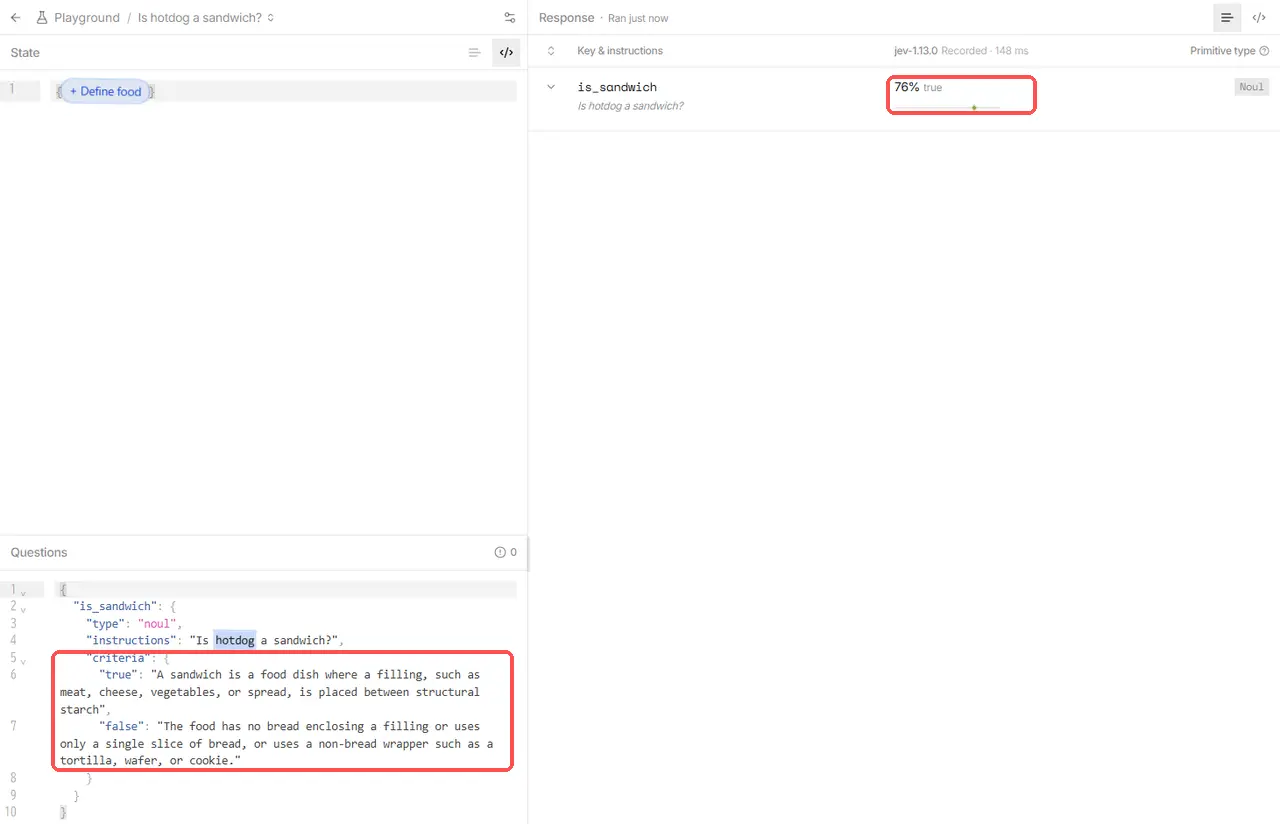
基準を書き足すと答えがはっきりし、状態を差し替えるだけで同じ質問を使い回せる、という流れがよく分かる練習でした。私は、Jevの使い方の要点がこの3回に詰まっていると感じました。
ただし、確かめきれていない点もあります。結果の上には「jev-1.13.0 Recorded」と表示されていて、練習問題では記録済みの結果を見せている可能性があります。また練習の途中では、答えの形のうち「選ぶ」と「採点する」に鍵のマークが付いていて選べませんでした。自分の文章で実行できるか、クレジットの購入が要るかは、この練習の範囲では確かめていません。登録した直後の残高は0ドルで、使った分だけ料金がかかる仕組みです。
開発者は、APIやVercel・Netlifyからも使える
開発者は、コンソールでAPIキーを作れば、プログラムからJevを呼べます。状態(state)と質問(questions)を送ると、質問ごとの答えが返ってきます。公式ドキュメントの例をもとにした、はい/いいえの質問の送り方は次のとおりです。
json
{
  "state": "Stripeとの連携が3日間うまくいかず、売上を失っています。至急助けてください。",
  "model": "jev-latest",
  "questions": {
    "urgency": {
      "type": "noul",
      "instructions": "このメッセージは急ぎの依頼か?"
    }
  }
}
答えは "urgency": { "type": "noul", "noul": 0.97 } のように、「はい」の確率で返ってきます(数値は例です)。Python、JavaScript、TypeScriptの開発用ライブラリもあり、詳しい手順は公式ドキュメントのQuick Startにまとまっています。
TypeSafe AIのアカウントがなくても、VercelのAI Gateway(モデル名は typesafe-ai/jev)や、NetlifyのAI Gatewayを通して使えます。料金は、それぞれのサービスの請求にまとまります。
OpenAIのDecisions APIなど、同じ種類のAIとの違い
Jevの後を追うように、「文章を書かずに判断だけを返すAI」は各社から出始めています。代表的なのが、OpenAIが2026年10月6日に公開ベータにしたDecisions APIです。
報道によれば、OpenAIの担当者は、Jevが「このすべてのきっかけになった」と話しています。Decisions APIは、GPT-6 Lunaを使い、答えの形を3種類に限って判断を返します。同じ時期には、CloudflareやAWSも、似た種類のモデルを出したと報じられています。
JevとDecisions APIを、出しているところ、答えの形、入力で比べます。
| 比べる点 | Jev | Decisions API |
|---|---|---|
| 出しているところ | TypeSafe AI | OpenAI |
| 中のモデル | Jev(判断のために作ったモデル) | GPT-6 Luna(LLMの答えを判断の形に絞る) |
| 答えの形 | はい/いいえ(Noul)、選ぶ(Choice)、採点する(Score) | はい/いいえ(predicate)、選ぶ(choice)、採点する(score) |
| 入力 | テキスト(画像は実験機能) | テキストと画像 |
| 提供の段階 | 早期アクセス | 公開ベータ |
※ 表の内容は2026年10月時点のものです。
答えの形はほぼ同じで、名前が違うだけです。開発者向けの中継サービスの中には、同じ書き方のまま、モデル名を変えるだけでJevとDecisions APIを切り替えられるものも出ています。
私は、ここで優劣を決める必要はないと考えています。画像を判断させたいならDecisions API、テキストの判断を大量に安く回したいならJev、というように、入力と使い方で選ぶのが自然です。種類そのものが広がり始めたことのほうが大事で、「判断の部品を、どこのモデルにするかを差し替えられる形で組んでおく」のが、長く使える作り方だと見ています。
うまくいかないときの対処と、使う前の注意点
Jevで思った答えが出ないときは、まず質問を小さく分け、次に判断の基準を書き足すのが近道です。私が手間の少なさと効き目の大きさで考えた順に並べます。
- 質問を1つのことに絞る: 2つ以上のことを1問で聞いていないかを見直す。分けて、組み合わせはコードで行う
- 判断の基準(criteria)を書き足す: 「はい」と「いいえ」の境目を文で書く。練習問題でも、基準を足すと58%から76%にはっきりした
- 状態から関係のない情報を外す: 判断に要る情報だけを渡す
- 計算・数え上げ・日付の比較はコードに任せる: Jevが苦手な部分を、確実に動くコードに回す
- 確信度の区切りを、自分のデータで決め直す: 例の値をそのまま使わず、実際の入力で試して調整する
この順にしたのは、1と2は質問の文を変えるだけですぐ試せて、効果も大きいからです。3〜5は仕組みの側の手直しなので、1と2で足りないときに進めるのがよいと私は考えています。
使う前に知っておきたい注意点もまとめます。
- 答えの形が合っていても、答えが正しいとは限らない: 決めた候補の中で間違えることはある。大事な判断は、確信度の低いものを人が確かめる
- 文章は書けない: 理由の説明やメールの下書きが要るなら、LLMと組み合わせる
- 入力した内容は外部に送られる: 個人情報や社外秘の情報の扱いは、会社のルールを確かめてから
- 速さは送る場所で変わる: サービスは米国西海岸にあり、開発元も、どこから送るかで速さが変わると書いている
- 早期アクセスで、条件が変わりやすい: 料金、受付の状況、版、対応する入力は短い間に変わる。開発元は、補助金で安くしている可能性を自分では否定しきれないとしている(利益は出ていると説明)
- 日本語の精度は自分で確かめる: 2026年10月14日のjev-1.14.0は、多言語の対応がいちばん良くなったと説明されている。日本語の文章で使うなら、自分のデータで試してから決める
Jevのよくある質問
Jevは無料で使えますか?
完全に無料とは言えません。 料金は入力100万トークンあたり0.042ドルで、出力は無料です。私が登録した直後の残高は0ドルで、練習問題は進められましたが、自分の文章での実行は確かめていません。手軽に試すなら、ログインせずに開けたGMO天秤AIのお試し環境があります。
Jevは日本語で使えますか?
日本語の文章も判断させられます。 2026年10月14日のjev-1.14.0では、多言語の対応がいちばん良くなったと説明されています。コンソールの画面は英語なので、日本語の画面で試したいならGMO天秤AIのお試し環境が向いています。
JevはChatGPTの代わりになりますか?
なりません。役割が違います。 Jevは会話も文章を書くこともできず、決めた形の判断だけを返します。文章を書く仕事はChatGPTなどのLLM、はい/いいえや振り分けを大量にこなす仕事はJev、と組み合わせて使うものです。
Jevは誰が作ったのですか?
米国サンフランシスコのTypeSafe AIです。 創業者でCEOのディオゴ・アルメイダ氏は、OpenAIでChatGPTの土台になった研究に関わった人物です。2026年9月15日に、Jevと一緒に表に出ました。
Jevの読み方は?
「ジェヴ」と読まれています。 日本で試せる環境を公開したGMO天秤AIの表記です。名前は経済学者のジェヴォンズに由来しますが、TypeSafe AIは公式の読み方を2026年10月時点で示していません。
Jevを仕事の道具にするために
最後に、この記事の要点を振り返ります。
- Jevは、文章を書かずに「選ぶ・採点する・はい/いいえ」の判断だけを返すAIで、答えの範囲を先に決めるから速く、安く、形が崩れない
- 答えの形が合っていることと、答えが正しいことは別。「幻覚ゼロ」は「間違えない」という意味ではない
- 確信度を使い、自信の高い判断は機械に任せ、低いものだけを人に回すのが基本の使い方
- 「193倍速い」などの数字は開発元の評価なので、自分の仕事で小さく試して確かめる
今日できることは、自分の仕事の中から「人なら数秒で決められる判断」を1つ書き出してみることです。問い合わせの振り分け、申請の不備の確認、口コミの良し悪しなど、何でもかまいません。それを「はい/いいえ」か「選ぶ」の質問に書き直し、GMO天秤AIのお試し環境で一度試してみてください。どの判断を機械に任せ、どれを人が見るべきかが、具体的に見えてくるはずです。